Intelligence artificielle


Introduction

Entre 1970 et 2010, le nombre de transistors présents sur une puce de microprocesseur a doublé en moyenne tous les deux ans. Depuis, cette vitesse d'amélioration des performances a ralenti, en raison de limites physiques à la miniaturisation et de coûts croissants des matériaux.
Le ralentissement de la croissance des capacités du matériel ("hardware") a été compensées par des progrès substantiels au niveau des données, en termes :
- quantitatif : Internet donne accès à des quantités gigantesques de données (web des objets) ;
- qualitatif : les technique de traitements statistiques des données, notamment par la méthode des "réseaux de neurones" artificiels).
L'IA avait connu une première vague dans les années 1980 sous le nom de "systèmes experts". Il s'agissait d'une IA "symbolique", caractérisée par l’utilisation de règles logiques pour résoudre des problèmes, simulant un raisonnement déductif (exemple : si..., alors...). Peu performante dans les problématiques instables et ouvertes, elle a aujourd'hui fait place à une IA dite "connexionniste", qui se fonde sur une analyse probabiliste de données, simulant un raisonnement inductif [source]. Les ordinateurs ont ainsi acquis des capacités d'apprentissage statistique non supervisé (c-à-d sans intervention humaine pour catégoriser les données d'entrée).
Les années 2010 ont boosté l'IA, en complétant l'approche symbolique par la méthode connexionniste :
| IA symbolique | 1997 | Le superordinateur Deep Blue bat les meilleurs joueurs de jeu d'échec. |
| IA connexionniste | 2013 | Google Speech-to-Text reconnaît des sons. |
| 2015 | Le logiciel AlphaGo bat les meilleurs joueurs du jeu de Go. | |
| 2016 | Amazon Rekognition reconnaît des formes. | |
| 2023 | chatGPT est capable de soutenir une conversation qui est systématiquement cohérente ("bluffante") au niveau de la forme et du sens, et souvent cohérente au niveau du fond. |
On peut ainsi résumer les deux types d'IA, historiques et complémentaires :
l’IA symbolique :
- sélection de données par arbres de décision (minimax) ;
- traitement des données exhaustif et déductif.
l’IA connexionniste:
auto-apprentissage par renforcement, au moyen de réseaux de neurones, à partir de base de données pouvant être initialement très petites (par exemple les seules règles du jeu de Go), puis enrichies par entraînement (par exemple les résultats d'une grande série d'auto-jeux)
- traitement des données probabiliste et inductif.
Ainsi pour reconnaître un chat dans une image, l'IA symbolique nécessite des règles explicites très détaillées sur ce qui constitue un chat (forme des oreilles, présence de moustaches, etc.), tandis qu'une IA connexionniste peut apprendre à reconnaître un chat après avoir été exposée à des milliers d'images, développant sa propre compréhension des caractéristiques pertinentes.
L'IA n'est pas simplement une évolution de l'informatique traditionnelle. Elle représente un changement de paradigme où les systèmes deviennent plus autonomes et adaptatifs (capacités d'auto-apprentissage) et acquièrent des capacités nouvelles fondamentales (notamment le traitement du langage naturel et la vision par ordinateur). Ce "saut évolutionniste" fut rendu possible par les niveaux atteints en terme de capacités de collecte de données (sur Internet), de leur stockage (mémorisation) et traitement (vitesse de calcul des processeurs), et qui sont telles qu'un simple ordinateur portable dépasse aujourd'hui les capacités humaines dans un nombre croissant de fonctions cognitives.
Les progrès futurs dans l'IA résident probablement dans le développement de processeurs biologiques (moindre consommation d'énergie) et quantiques (extrêmement plus rapides).
Enfin, deux problématiques majeures de l'IA sont son énorme consommation énergétique, et un "risque existentiel " pour l'humanité.
Analogies
Lecture préalable recommandée : democratiedirecte.net/intelligence, qui traite des intelligences individuelles et collective.
On pourrait oser l'analogie suivante entre informatique et humains:
| Physique | Biologie |
|---|---|
| ordinateur | os, muscles et organes |
| logiciels | cerveau |
| électricité | aliments et sang |
| bits | acides aminés (composants des protéines, molécules élémentaires) |
| réseau | la société humaine |
Il importe cependant de souligner des différences de nature fondamentales entre systèmes physiques et biologiques :
| Critères | Systèmes physiques | Systèmes biologiques |
|---|---|---|
| Composition | Matière inanimée | Matière vivante |
| Énergie | Utilisation directe | Métabolisme complexe |
| Information | Externe ou limitée | Interne (ADN) et évolutive |
| Adaptabilité | Faible | Très élevée |
| Organisation | Externe | Auto-organisée |
| Reproduction | Impossible | Possible |
| Entropie | Tendance au désordre | Maintien de l'ordre |
| Finalité | Fixée par un concepteur | Survie et reproduction intrinsèques |
Les analogies sont utiles pour favoriser la compréhension de notions nouvelles, à condition de les utiliser à bon escient. Ainsi pour voler l'homme à inventé des machines très différentes des oiseaux (leur propulsion n'est pas réalisée par le mouvement des ailes, mais par des réacteurs). Ainsi les méthodes modernes en matière d’IA tendent à se concentrer sur la division d’un problème en un certain nombre de problèmes plus petits, isolés et bien définis, et à les résoudre l’un après l’autre. Cette démarche contourne les grandes questions sur le sens de l’intelligence, de l’esprit et de la conscience, en se concentrant sur la mise en place de solutions pratiques à des problèmes concrets.
D'autre part, selon Laurent Bloch, « les travaux qui fournissent les emplois d'aujourd'hui (et fourniront plus encore ceux de demain) sont ceux qui ne peuvent se passer de l'intervention humaine, parce qu'ils font appels à l'intellection, ou à l'affectivité, ou à l'intuition, ou à une combinaison de ces trois aptitudes auxquelles ne peuvent suppléer ni les algorithmes ni même l'IA ».
Mais si l'IA parvenait à simuler l'intellection, l'affectivité et l'intuition, ne pourrait-elle pas alors simuler ce que ces aptitudes humaines permettent de réaliser ?
Bloch semble convaincu que l'IA ne pourra jamais accéder au sens des énoncés du langage, notamment parce qu' « ils sont infléchis par l'influence du contexte dans lequel ils se donnent, or le contexte est indéfini, et infini, ce sont même ses caractéristiques principales. Indéfini parce qu'il est propre à chaque individu, infini, parce qu'il se prolonge jusque dans notre inconscient, et dans celui de nos ancêtres, ainsi que dans nos expériences sensorielles les plus intimes » [source].
Définition
Dès lors qu'il n'existe de consensus scientifique sur ce qu'est l'intelligence individuelle, il en est de même pour l'IA.
Néanmoins, une possible définition [source] est qu'une machine peut être qualifiée "d'intelligente" si elle vérifie les deux propriétés suivantes :
- autonomie : capacité d’exécuter des tâches dans des environnements complexes, sans guidage constant de la part d’un utilisateur;
- adaptabilité : capacité d’améliorer les performances grâce à l’apprentissage par l’expérience.
Quant à l'incarnation physique de l'IA, c-à-d l'ordinateur, celui-ci est un "automatique programmable universel" [source].
Matériel
2. Électronique
3. Données en bits
Architecture
de Turing
En 1936 le mathématicien Alan Turing proposa un modèle théorique de calcul, développé dans le but de comprendre les limites de ce qui peut être calculé par une machine. La "machine de Turing" est constituée d’une bande infinie de mémoire divisée en cellules, une tête de lecture/écriture qui peut se déplacer sur cette bande, et un ensemble d'états qui régissent le comportement de la machine.
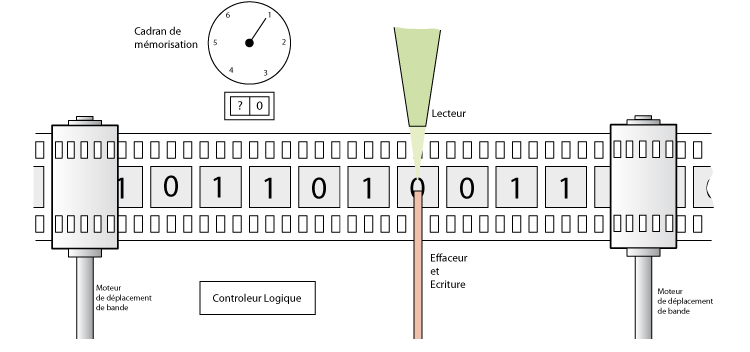
Détail des trois composants de la machine de Turing :
une bande infinie divisée en cellules, où chaque cellule peut contenir un symbole.
une tête de lecture/écriture qui peut lire et écrire des symboles sur la bande et se déplacer dans les deux sens.
- une table de transition qui spécifie les opérations basées sur l'état actuel et le symbole lu :
- un ensemble fini d’états parmi lesquels on distingue un état initial et les autres états, dits accepteurs ;
une fonction de transition qui, pour chaque état de la machine et chaque symbole figurant sous la tête de lecture, précise :
- l’état suivant ;
- le caractère qui sera écrit sur le ruban à la place de celui qui se trouvait sous la tête de lecture ;
- le sens du prochain déplacement de la tête de lecture.
von Neumann
Au début des années 1940, le mathématicien John von Neumann proposa un modèle d'architecture de calcul, avec une mémoire centrale (où les programmes et les données sont stockés), un processeur qui exécute les instructions, et une unité de contrôle qui gère l'exécution des programmes :
- Unité Centrale de Traitement (CPU) :
- unité de Contrôle : supervise l’enchaînement des instructions dans l’ordre indiqué par un programme.
- unité Arithmétique et Logique : effectue les opérations arithmétiques et logiques.
l'ALU (acronyme en anglais) contient les circuits logiques des instructions (les instructions sont des objets physiques, en l’occurrence des circuits électroniques qui réalisent ces opérations conformément aux règles de l’algèbre de Boole, qui permet de modéliser des raisonnements logiques selon un formalisme qui se prête bien à la réalisation par des circuits électroniques) [source].
- accumulateur : registre utilisé pour stocker les résultats des opérations intermédiaires.
- Mémoire :
- contient à la fois les données et les instructions.
- les adresses mémoire permettent d'accéder aux différentes valeurs stockées.
- Bus (flèches) : pour le transfert des adresses mémoire, données et signaux de contrôle.
- Interfaces d'entrée et de sortie :
- entrée : permet de recevoir des données externes (clavier, souris, etc.) qui sont stockées en mémoire ou utilisées directement.
- sortie : permet d'envoyer des données traitées à l'extérieur (écran, imprimante, etc.).
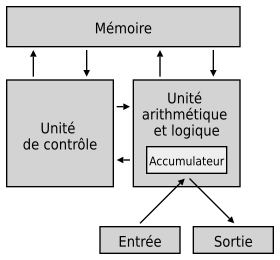
Les deux principes à la clé de l’architecture de von Neumann sont l’exécution séquentielle et le partage d’une mémoire unique pour les instructions et les données du calcul [source p.51]. Source image.
Exemple pratique : addition de deux nombres [source : chatgpt.com] :
- Saisie des données depuis l'entrée :
- L'opération 5 + 3 est introduite via un périphérique d'entrée (par exemple, un clavier).
- Ces données sont stockées dans des emplacements mémoire distincts :
• A pour 5
• B pour l'opérateur +
• C pour 3
- Chargement des données et de l'opérateur :
- L'unité de contrôle récupère l'instruction LOAD A, qui charge le nombre 5 dans l'accumulateur.
- L'instruction LOAD C est ensuite récupérée pour charger le nombre 3 dans un autre registre.
- Exécution de l'addition :
- L'unité de contrôle identifie l'opérateur + stocké dans B et commande à l'UAL (Unité Arithmétique et Logique) d'effectuer l'addition.
- L'UAL ajoute le contenu de l'accumulateur (5) avec le nombre stocké dans l'autre registre (3), en utilisant l'opérateur +.
- Le résultat 8 est stocké dans l'accumulateur.
- Stockage du résultat : l'instruction STORE D est exécutée pour stocker le résultat 8 dans l'adresse D en mémoire.
- Envoi du résultat sur le périphérique de sortie : Le résultat 8 est récupéré de la mémoire et envoyé à un périphérique de sortie (par exemple, un écran) pour être affiché.
Selon Samuel Goyet, « avant von Neumann, programmer c’était tourner des boutons et brancher des fiches dans des tableaux de connexion, depuis von Neumann c’est écrire un texte » [source, p.412, édition 2024].
Le traitement simultané de plusieurs opérations est-il possible ?
En théorie, non. En pratique, oui. Un ordinateur ne peut théoriquement traiter plusieurs instructions séparément. Cependant, en pratique, des ordinateurs à plusieurs processeurs peuvent exécuter plusieurs programmes simultanément. L'illusion de simultanéité provient du fait que pour un humain les délais d'action et de perception sont respectivement de l'ordre du dixième et centième de seconde, alors qu'un processeur peut traiter plusieurs centaines de millions d’instructions par seconde, ce qui correspond à quelques nano-secondes (milliardièmes de seconde) par instruction, soit un ordre de grandeur huit à neuf fois inférieur. Par conséquent, une tranche de temps de quelques fractions de seconde, partagée entre plusieurs processus, donne à l’échelle macroscopique de la perception humaine l’illusion de la simultanéité [source p.48].
Électronique
Le matériel informatique ("hardware") – en l'occurrence le processeur – étant composé de systèmes électroniques, il ne peut traiter et stocker que des données binaires, en l'occurrence des 1 (présence de courant) et des 0 (absence de courant). Ce matériel ne peut donc interagir qu'avec des programmes/logiciels ("software") écrits en langage binaire. Les programmes informatiques écrits par des humains doivent donc être convertis/traduis en ce langage machine pour pouvoir être exécutés par le processeur.
L’unité centrale de l’ordinateur est constituée de circuits logiques, qui réalisent matériellement les opérations de la logique, et à partir de là les opérations arithmétiques élémentaires. Un circuit logique fonctionne sur base d'un dispositif dit semi-conducteur, qui en fonction d’un courant de commande laisse passer ou bloque un courant entre une source et un collecteur [source, p.401, édition 2024]
Le transistor est un composant électronique à semi-conducteur permettant de contrôler ou d'amplifier des tensions et des courants électriques au sein d'un circuit logique.
Transistors vs neurones
L'analogie entre un neurone et un transistor réside dans leur capacité à traiter des signaux et à contrôler leur transmission. Là où les transistors gèrent des signaux électriques de manière binaire ou analogique dans les circuits électroniques, les neurones traitent des signaux chimiques et électriques dans les réseaux neuronaux biologiques :
- Traitement et Transmission des Informations :
Transistor : dans les circuits intégrés, les transistors sont assemblés en réseaux complexes pour traiter l’information sous forme de bits (0 et 1), permettant aux ordinateurs de réaliser des calculs.
Neurone : dans le cerveau, les neurones sont également interconnectés en réseaux très complexes pour traiter des informations sensorielles, motrices et cognitives, permettant au cerveau de réaliser des fonctions d'apprentissage, de mémoire et de perception.
- Trois Points de Connexion :
Transistor : un transistor a trois points de connexion principaux : l'entrée, la sortie, et la borne de commande.
Neurone : un neurone a des dendrites pour la réception d'information (équivalent à l'entrée), un axone pour transmettre le signal (équivalent à la sortie), et le soma (corps cellulaire) qui agit comme le centre de décision (équivalent de la borne de commande).
- Fonction de Contrôle du Signal :
Transistor : il agit comme un commutateur ou amplificateur de signal, contrôlant le passage du courant entre deux bornes en fonction du signal appliqué à sa borne de commande.
Neurone : le neurone reçoit des signaux d'autres neurones (par ses dendrites), intègre ces signaux, puis produit un signal de sortie (potentiel d'action) transmis via l'axone si le seuil de stimulation est atteint.
- Fonctionnement tout-ou-rien :
Transistor : dans les circuits numériques, le transistor agit souvent en mode tout-ou-rien, passant de l’état « off » (pas de courant) à l’état « on » (courant maximal), ce qui est la base des circuits logiques.
Neurone : le neurone suit aussi une logique de type tout-ou-rien pour le potentiel d’action. Lorsqu’il reçoit suffisamment de stimulation pour dépasser un seuil, il génère un potentiel d’action. Sinon, il reste « au repos », sans émettre de signal.
- Modulation de Signal :
Transistor : en mode analogique, le transistor peut amplifier les signaux faibles. La modulation de la tension ou du courant à la borne de commande permet de contrôler le flux de courant entre les deux autres bornes.
Neurone : le neurone intègre les signaux excitateurs et inhibiteurs reçus de plusieurs autres neurones. Si la somme des signaux reçus dépasse un certain seuil, il déclenche une réponse de sortie. Cette intégration et sommation de signaux est une forme de modulation de signal.
- Effet de Seuil et Filtrage :
Transistor : le transistor a un seuil de tension ou de courant à partir duquel il commence à conduire entre ses bornes principales.
Neurone : le neurone possède également un seuil d’activation pour le déclenchement du potentiel d'action, ce qui agit comme un filtre pour éviter de répondre à des stimulations faibles ou aléatoires.
Le transistor bipolaire est le plus simple. Les circuits actuels utilisent plutôt des transistors à effet de champ, qui autorisent des densités plus élevées, mais avec des circuits plus complexes,
Transistor bipolaire
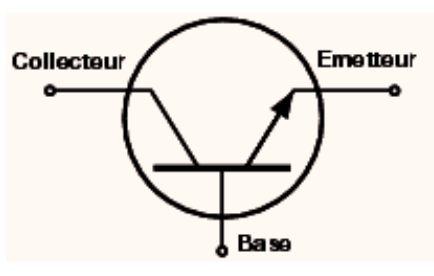
Quand la base est mise à une tension positive, le courant passe du collecteur à l’émetteur ; quand la base est mise à une tension négative ou nulle, le courant ne passe pas [source, p.401, édition 2024].
L'utilisation des transistor comme circuits logiques repose sur l'algèbre de Boole, qui repose sur deux notions :
- une épreuve (action) : par exemple tirer sur un cible ;
- un événement (résultat) : l'endroit de l'impact sur la cible :
- A : l'impact est situé dans la partie supérieure de la cible ;
- B : l'impact est situé dans la partie droite de la cible ;
Algèbre de Boole
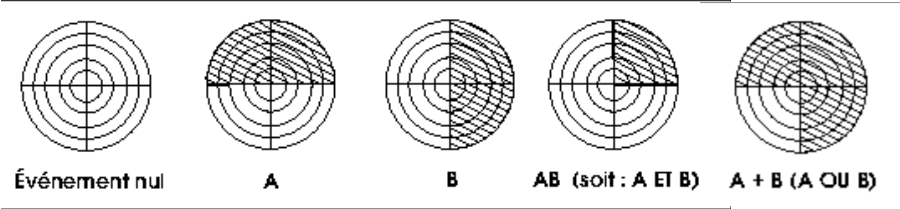
Quand la base est mise à une tension positive, le courant passe du collecteur à l’émetteur ; quand la base est mise à une tension négative ou nulle, le courant ne passe pas [source, p.403, édition 2024].
- l'événement "A et B" est noté A ∧ B ou A * B (ou AB) car correspond à un produit d'événements ;
- l'événement "A ou B" est noté A ∨ B ou A + B car correspond à une somme d'événements ;
- l'événement "non A" est noté A− : ainsi soit C = A ∨ B alors C− correspond au cadran inférieur gauche.
On introduit l'algèbre dans ces raisonnements logiques au moyen d'une table de vérité, qui consiste à attribuer à chaque résultat deux valeurs possibles :
- 1 : vrai, courant positif ;
- 0 : faux, courant nul.
| x | y | x*y | x+y |
|---|---|---|---|
| 0 | 0 | 0 | 0 |
| 0 | 1 | 0 | 1 |
| 1 | 0 | 0 | 1 |
| 1 | 1 | 1 | 1 |
L'algèbre de Boole est numérique et logique (0 * 0 = 0), tandis que l'algèbre de l'électricité correspond à des phénomènes physiques (- * - = +).
des circuits
« Les circuits ci-dessous comportent des résistances, symbolisées par des fils en zigzag, qui comme leur nom l’indique font obstacle au passage du courant. Si le courant trouve un chemin plus facile, comme par exemple un transistor à l’état passant, il ne franchira pas la résistance (plus exactement, le courant qui franchira la résistance sera faible et inférieur au seuil qui le rendrait efficace). Mais s’il n’y a pas d’autre chemin, par exemple parce que le transistor est à l’état bloqué, le courant franchira la résistance » [source, p.404, édition 2024]..
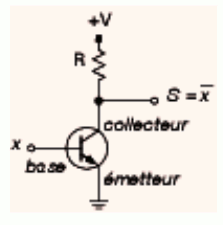
Circuit "NON". Si x=0, la base du transistor est à un potentiel nul, le transistor est bloqué ; via la résistance, le courant positif va arriver en sortie x−, qui vaudra donc 1, ce qui est bien le contraire de 0. Si x=1, le courant positif atteint la base du transistor qui devient passant. De ce fait, le point x est directement relié à la masse, donc à une tension nulle et vaudra 0, ce qui est le résultat voulu.
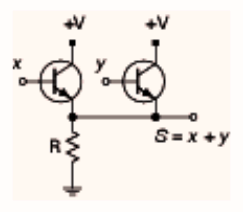
Circuit "OU". « Nous avons deux transistors en parallèle : pour que le courant positif parvienne à la sortie notée x+y et lui confère ainsi la valeur 1, ou le vrai, il suffit que l’un des deux transistors soit passant. Pour cela il suffit que l’une des deux entrées, x ou y, soit positive : en effet un courant positif en x par exemple l’emportera sur la mise à la masse générée par R. C’est bien le résultat attendu. ».
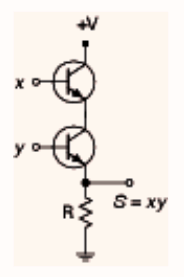
Circuit "ET". « Nous avons deux transistors en série : pour que le courant positif atteigne la sortie notée xy il faut que les deux transistors soient passants, et donc que les deux entrées x et y soient positives, ce qui est bien le résultat voulu, conforme à la sémantique du ET. ».
Laurent Bloch explique brillamment comment une position de mémoire élémentaire, qui représente un bit, est obtenue en combinant deux circuits NON OU de telle sorte que la sortie de l’un alimente l’entrée de l’autre, et réciproquement : source, p.409, édition 2024.
Moore
Entre 1970 et 2010, le nombre de transistors présents sur une puce de microprocesseur a doublé en moyenne tous les deux ans (loi de Moore). Depuis, cette vitesse d'amélioration des performances a ralenti, en raison de limites physiques à la miniaturisation et de coûts croissants des matériaux.
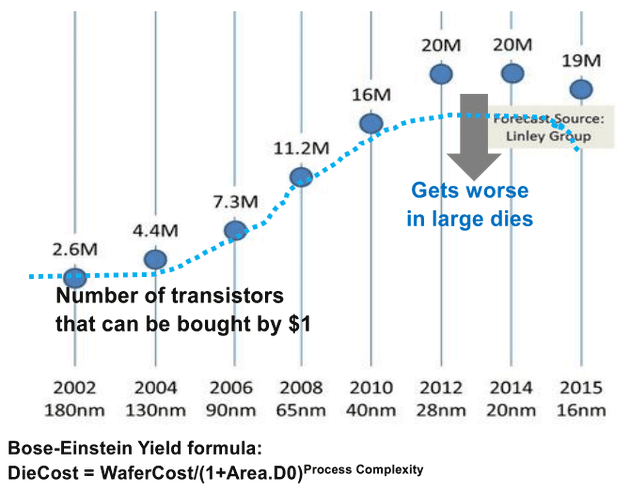
Source : hardware.fr
Semi-conducteurs, transistors, circuits intégrés et microprocesseurs.
Ces quatre notions, parfois confondues, sont pourtant à distinguer : les premiers sont la base matérielle des transistors, ceux-ci sont regroupés dans des circuits intégrés et ces derniers lorsqu’ils permettent avec une unité unique de faire fonctionner un ordinateur prennent le nom de microprocesseurs.
Dès 1833, Faraday constate qu’à la différence de la plupart des métaux dont la résistance augmente avec la température, certains métaux comme le sulfate d’argent sont de plus en plus conducteurs avec la hausse de la température (coefficient de température négatif)3. Un siècle plus tard, en 1931, Wilson théorise les semi-conducteurs : les électrons forment des ondes dans les solides et la conduction électrique de certains matériaux varie en fonction de divers facteurs comme la température, le courant électrique ou la lumière.
La loi de Moore (doublement du nombre de transistors présents sur une puce de microprocesseur tous les deux ans) fut observée empiriquement jusqu’aux années 2010. La contrepartie de cette loi de Moore – fondée sur la réduction de la taille des traits gravés dans le silicium permettant d’augmenter la densité des processeurs et par conséquent leur vitesse – est la « loi de Rock » (du nom d’Arthur Rock) selon laquelle le coût d’une fonderie de semi-conducteurs double quant à lui tous les quatre ans, sous l’effet de procédés de fabrication de plus en plus chers. Cependant, le mur des limites physiques des microprocesseurs, avec le fait d’approcher de la taille moléculaire, est aujourd'hui atteint ...
Fin 2004, la première entreprise au monde (tous secteurs confondus) en terme de chiffre d'affaire est la société états-unienne Nvidia qui conçoit des puces (mais sous-traite leur fabrication à l’entreprise de fonderie taïwanaise TSMC). La production de semi-conducteurs en silicium est un marché assez monopolistique, car les coûts fixes sont prépondérants, ce qui le rapproche des conditions d’un monopole naturel.
[source].Données en bits
Pour traiter des informations, les ordinateurs doivent les convertir en données sous forme de bits. Le bit est l'unité la plus simple dans un système de numération, ne pouvant prendre que deux valeurs, désignées le plus souvent par les chiffres 0 et 1. Dans un ordinateur, c-à-d un système électronique, la valeur 1 correspond au passage d'un courant électrique (ou une tension spécifique), et la valeur 0 à son absence.
Les ordinateurs quantiques fonctionnent quant à eux à l'aide de bits quantiques, ou qubits, qui peuvent :
- exister dans des états de superposition : par exemple dans un état correspondant à 0 pour une probabilité de x %, dans un état correspondant à 1 pour une probabilité de 100-x %) ;
- être intriqués : l'état de l'un peut dépendre de l'état de l'autre, même si les deux qubits sont séparés par de grandes distances.
Grâce à ces deux propriétés, un processeur quantique peut traiter une quantité beaucoup plus grande de données, et cela en parallèle (alors qu'un processeur classique ne peut traiter les données que séquentiellement), de sorte que la vitesse de traitement d'une même quantité d'information est également beaucoup plus grande.
Nous allons ici développer quelques notions concernant la notion de bits dans le cadre des ordinateurs classiques.
Représentation informatique des nombres entiers [source, p.392, édition 2024]. Soit un ordinateur dont l’architecture matérielle met à notre diposition, pour représenter les entiers, des emplacements de n positions en base B (B étant paire). On peut alors représenter B n nombres différents. Ainsi une machine à mots de 32 bits autorisera des entiers compris entre - 232 / 2 et 232 / 2 - 1
Le plus grand nombre positif représentable a une valeur absolue plus faible de 1 que celle du plus petit nombre négatif représentable, parce que 0 est "avec" les nombres positifs.
Dans un ordinateur, un nombre négatif −p peut être représenté par le système du complément à deux, que l'on obtient en remplaçant chacun des chiffres de p par son complément à 1 (c’est-à dire en remplaçant chaque 1 par un 0 et chaque 0 par un 1) et en additionnant 1 au résultat. Prenons un exemple avec comme base B = 2 et n = 4 chiffres possibles. Ainsi le nombre +5 est représenté par les chiffres suivants : 0101 (cf. clipedia-txt.net/mesure#systemes-numerotation). Le complément à 1 de cette combinaison de chiffres nous donne : 1010. Additionnons 1 pour avoir le complément à 2 : 1011, qui représente −5 [source, p.393, édition 2024]. On a bien – en abandonnant la dernière retenue (puisque n=4) – que :
  0 1 0 1
+ 1 0 1 1
-----------
  0 0 0 0
Étapes du calcul :
- un plus un donne deux, je pose zéro et je retiens un ;
- un de retenu plus zéro plus un donne deux, je pose zéro et je retiens un;
- un de retenu plus un plus zéro donne deux, je pose zéro et je retiens un;
- un de retenu plus zéro plus un donne deux, je pose zéro et j'abandonne la dernière retenue.
L'avantage du système du complément à deux, pour le calcul automatique, est qu'il fait l'économie du signe négatif. Pour le calcul manuel on utilise plutôt le système binaire pur ;
  1 0 1 (5 en binaire)
- 0 1 1 (3 en binaire)
-----------
  0 1 0
Étapes du calcul :
- colonne de droite (unité) : 1 - 1 = 0
- deuxième colonne : 0 - 1
- comme 0 est inférieur à 1, on doit emprunter 1 de la colonne suivante.
- l’emprunt transforme cette colonne en 10 (ou 2 en décimal), donc 10 - 1 = 1.
- troisième colonne : après l’emprunt, cette colonne devient 0 (puisqu'on a emprunté 1), donc 0 - 0 = 0.
nombre
Nombre réels. Les nombres réels constituent avec les nombres imaginaire l'ensemble des nombres complexes : ℂ = ℝ +iℝ. Mais comment, dans un ordinateur, représenter les nombres fractionnaire c-à-d « avec des chiffres après la virgule » ? Dans une machine, le "nombre de chiffres après la virgule" est nécessairement limité par la taille physique des composants. C'est pourquoi les nombres fractionnaires sont représentés dans les registres des ordinateurs selon le principe de la virgule flottante, équivalente à la notation scientifique, qui consiste à écrire 197 * 106 plutôt que 197000000, selon le modèle signe × mantisse × baseexposant. La virgule flottante permet de définir une limite de l'erreur d'approximation relative d'une machine. La norme IEEE 754, qui définit différents formats (selon le degré de précision) de nombres fractionnaires, est appliquée sur la plupart des ordinateurs. Pour approfondir : clipedia-txt.net/mesure#systemes-numerotation.
La notion d'infini en informatique
L'infini est un concept mathématique (mais pas un nombre) qui est utilisé pour décrire une quantité qui ne peut être atteinte ou qui n'a pas de limite finie. Il est utilisé dans divers contextes, notamment dans les limites, les séries infinies, ou pour décrire les comportements asymptotiques.
Dans les calculs effectués par un ordinateur, l'infini n'est pas directement représenté comme un nombre concret. Ainsi en Python, on peut utiliser float('inf') pour obtenir une valeur infinie positive et float('-inf') pour l'infini négatif, et
>>> 1/float('-inf')
-0.0
plutôt que 0, car 1 / ∞ représente un comportement asymptotique, en l'occurrence proche de zéro, ce qui est représenté par 0.0 dans le système à virgule flottante.
Quant à l'expression ∞ / ∞ qui est mathématiquement une forme indéterminée, on aura :
>>> float('inf')/float('inf')
nan
Enfin :
>>> float('inf')+float('inf')
inf
https://democratiedirecte.net/intelligence#infini-informatique
Instructions
2. Systeme d'exploitation
3. Algorithme
Langages de programmation
Emmanuel Saint-James décrit la programmation comme la transmission d'un raisonnement à une machine, capable de le reproduire. Par cette reproduction l'ordinateur s'affirme comme un instrument d'objectivation du raisonnement. Il s'inscrit dans la lignée des appareils qui ont permis de passer de l'expérience empirique à l'expérimentation scientifique : l'informatique se distingue des mathématique par un outil d'expérimentation permettant d'observer, vérifier, réfuter un raisonnement [source].
Cette transmission d'un raisonnement à une machine s'effectue par le truchement d'un langage : l'ordinateur a un langage en lui, constitué d'instructions qui effectuent des opérations sur des données. Les instructions ne font pas que désigner une action, elles l'effectuent (opération d'exécution). Les instructions sont des objets physiques, en l'occurrence des circuits électroniques qui réalisent ces opérations conformément à l'algèbre de Boole. Le langage constitué des circuits électroniques est appelé "langage machine" [source]..
Le modèle théorique de la "machine de Turing" forme avec le λ-calcul la base de la théorie des langages de programmation.
Un processeur quelconque est caractérisé par le jeu des actions élémentaires qu’il est capable d’effectuer. Ces actions élémentaires sont appelées les primitives du processeur ("instructions machine"). Un programme pour un processeur de von Neumann est une suite de primitives du processeur destiné à l’exécuter. Chacune de ces instructions élémentaires correspond à un circuit logique du processeur considéré. L’ensemble des instructions machine et des règles de leur rédaction constitue le langage machine. Pour construire toutes les combinaisons possibles de primitives, il suffit à l'unité centrale du modèle de von Neumann de pouvoir [source p.29] :
- enchaîner deux primitives;
- répéter un primitive;
- choisir entre deux primitives selon le résultat d'un test.
« Un langage qui satisfait à toutes ces conditions est dit Turing-équivalent. C’est le cas des langages de programmation généraux, tels que C, Java, Lisp ou Fortran, mais il y a des langages non-Turing-équivalents et néanmoins très utiles, comme le langage SQL d’accès aux bases de données, HTML et XML pour décrire des documents, etc » [source].
vs informatique
Laurent Bloch définit la notion de traitement de l'information comme étant une « manipulation symbolique composée d’opérations de traduction et de réécriture ». Un traitement d'information est ainsi l'équivalent informatique de la notion mathématique de calcul. L'informatique c'est donc des mathématiques appliquées par des machines. On appelle ainsi procédure effective, la suite des opérations concrètes par lesquelles s’effectue un calcul, c-à-d la suite des opérations qui à partir de certaines données produiront certains résultats, constituant ainsi un traitement. C’est pour définir sans ambiguïté des procédures effectives que Turing a imaginé la machine de Turing. En particulier, les étapes du calcul/traitement doivent être enregistrées dans une mémoire. Ainsi la machine de Turing formalise les opérations de consultation et d’affectation de la mémoire. Le calcul sera terminé lorsque la mémoire sera dans un état qui contienne le résultat recherché. La mathématique ignore cette notion d’état, aspect physique qui caractérise l'informatique [source].
Le processus informatique d’affectation « opère une rupture radicale entre vision mathématique et vision informatique du calcul, elle y introduit un aspect dynamique, actif et concret qui est étranger aux mathématiciens. L’affectation (...) permet de modéliser un calcul par des états de mémoire successifs, bref c’est elle qui permet de réaliser des machines de Turing » [source p.83].
Ainsi l'expression i = i + 1 est fausse en mathématique, mais en informatique elle est correcte si le langage prévoit que le signe "=" n'exprime pas une égalité mais une affectation : i qui valait x vaut maintenant x+1. L'égalité pouvant être exprimée, en informatique, par le signe == (notamment en Python) ou === (notamment en JavaScript).
Selon Laurent Bloch, « un énoncé mathématique est essentiellement déclaratif (le "quoi"), il décrit les propriétés d’une certaine entité, ou les relations entre certaines entités. Un programme informatique est essentiellement impératif (ou performatif, le "comment"), il décrit comment faire certaines choses. Il est fondamentalement impossible de réduire l’un à l’autre, ou vice-versa, ils sont de natures différentes. Il est par contre possible, dans certains cas, d’établir une relation entre le texte d’un programme et un énoncé mathématique, c’est le rôle notamment des systèmes de preuve de programme » [source, p.413, édition 2024].
Une autre différence entre informatique et mathématique réside dans la notion d'erreur. Les erreurs de programmation se distinguent des erreurs de calcul ou de logique qui peuvent affecter une démonstration mathématique. Ainsi en informatique on peut distinguer trois types d'erreur [source] :
- les erreurs de programmation :
erreurs de syntaxe : mais le compilateur la détectera généralement et donnera des explications qui aideront à sa correction) ;
erreurs de sémantique : le programmeur a mal compris le manuel du langage, et il écrit un texte dont il pense qu’il va donner le résultat voulu, alors qu’il va donner un autre résultat, ou un programme faux, qui ne se termine pas, ou qui se termine par une erreur explicite. Les méthodes de preuve de programmes ne pourront aider que dans certains cas assez particuliers, parce qu’elles sont trop lourdes pour être appliquées à l’ensemble d’un programme (un système d’exploitation général comprend plusieurs plusieurs millions de lignes de texte, plusieurs dizaines de millions si l’on y inclut les interfaces graphiques interactives).
les erreurs techniques : l’exécution d’un programme informatique peut échouer pour une raison qui n’est pas à proprement parler une erreur de programmation mais liée au contexte technique. Ainsi, un programme qui écrit des données sur disque peut échouer si le disque est plein. La saturation de la mémoire est une autre cause d’échec courante. En principe ces circonstances sont prévisibles par celui qui lance le programme, mais pas par celui qui l’écrit.
Système d'exploitation
Un logiciel, ou programme informatique, est un fichier constitué de commandes/instructions que l'ordinateur applique pour traiter des données, interagir avec un utilisateur ou encore contrôler du matériel.
Les logiciels se divisent généralement en deux grandes catégories :
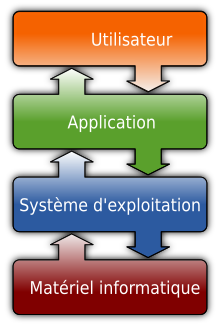
- les logiciels applicatifs – comme les navigateurs, les éditeurs de texte ou encore les jeux vidéo – servent directement à l’utilisateur pour accomplir une tâche.
-
les logiciels systèmes constituent le système d'exploitation (SE : Windows, macOS, Linux, ), qui est l'ensemble des programmes dont un ordinateur a besoin pour fonctionner (démarrage, gestion de la mémoire, des matériels périphériques, etc.).
L'utilisateur avancé peut interagir avec le SE au moyen d'applications (interfaces graphiques) spécifiques ou directement via des commandes dont l'ensemble est appelé shell. Ces commandes peuvent être combinées pour constituer des algorithmes (on dit aussi routines ou programmes) qui automatisent certaines procédures.
Le bloc "Utilisateur" du schéma ci-dessus doit être interprété au sens large, c-à-d y compris d'autre utilisateurs sur le réseau auquel il est connecté. Le schéma suivant illustre la connexion de l'ordinateur au réseau.
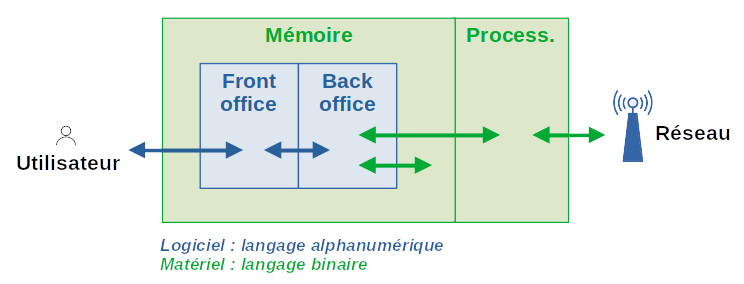
Le schéma ci-dessus inclus également des notions non mentionnées dans le schéma précédent : la mémoire et le processeur de l'ordinateur, éléments fondamentaux de son architecture (cf. supra #IA-architecture-materielle), et qui permettent d'illustrer la différence entre langages alphanumérique (ou "utilisateur") et binaire (ou "machine").
- le langage alphanumérique est utilisé par les humains pour écrire des programmes ;
- ceux-ci doivent ensuite être traduits en langage binaire, pour pouvoir être utilisables par le processeur.
La traduction entre langage alphanumérique (flèches bleues du schéma supra) et langage binaire (flèches vertes) peut se faire de deux façons : interprétation ou compilation. L'interprétation va traduire en temps réel à chaque fois que l'application sera lancée chez l'utilisateur, alors que la compilation traduit une seule fois en amont chez le développeur :
langage interprété :
processus : le code source est traduit en langage machine à la volée par l'interprète pendant l'exécution, sans générer de code binaire complet précompilé.
avantage : le même code source peut être utilisé sur tous les types d'ordinateurs ... équipés de l'interprète approprié (un logiciel).
inconvénient : tendance à être plus lent en raison de la traduction en temps réel.
exemple : les interpréteurs JavaScript, comme ceux intégrés dans les navigateurs web, exécutent le code JavaScript des pages web.
langage compilé :
processus : le code source est entièrement traduit en un code objet en langage machine (code binaire) avant l'exécution par le processeur.
avantage : rapidité d'exécution, car le code binaire est prêt à être exécuté directement par le processeur (notion de "fichier exécutable").
inconvénient : un même code source doit être compilé pour chaque type d'ordinateur (c-à-d du type de processeur et de système d'exploitation).
Interprétation vs compilation

Il y a donc un compilateur pour chaque type spécifique d'ordinateur (X86, ARM, ...). Autrement dit, pour fonctionner sur un autre type de processeur, un programme compilé doit être recompilé pour ce type d'ordinateur.
Commentaires :
Interprétation (gauche). Même si un langage interprété ne produit pas de code binaire natif avant l'exécution, les instructions doivent toujours être exécutées en langage machine car c'est la seule forme que le processeur peut comprendre. La différence réside principalement dans le moment et la méthode de traduction par rapport aux langages compilés. En résumé, les langages interprétés sont exécutés sans passer par une compilation préalable en code machine binaire, mais ils sont traduits en instructions machine au moment de l'exécution par l'interprète.
Compilation (droite). Avant de traduire le code source en code assembleur, le compilateur procède à une optimisation du code source. D'autre part, le compilateur peut directement générer du code machine (ou du bytecode, comme en Java), mais souvent il génère du code assembleur intermédiaire.
- Mixte. Certains langages, comme Java, utilisent une combinaison des deux approches (compilation en bytecode et interprétation par une JVM avec optimisation JIT). Ce modèle permet une portabilité élevée, mais introduit des vecteurs d'attaque spécifiques, notamment au niveau de la JVM.
Plus on monte dans la hiérarchie des langages, plus on gagne en abstraction, moins on a à s'occuper du fonctionnement physique de l'ordinateur, et plus les programmes peuvent fonctionner indifféremment sur des ordinateurs de types différents. Mais cette abstraction a un prix qui se paie en efficacité. Et pour écrire les programmes du système d'exploitation, qui établissent le lien entre ce que perçoivent les programmeurs et ce qui se passe dans les circuits, on aura toujours besoins de langages de bas niveau, tels que C, Rust ou même des langages assembleurs [source].
Selon Laurent Bloch, le SE est sans doute l'objet le plus technique de notre époque. De surcroît il doit évoluer en permanence. Chaque jour arrivent sur le marché de nouveaux matériels tels que les cartes graphiques, caméras, disques durs, mémoire Flash, qui nécessitent l'écriture de nouveaux pilotes. L'apparition de nouveaux virus et la découverte de nouvelles failles de sécurité obligent à corriger le SE [source].
Menaces sur l'informatique libre
Les fabricants de matériels informatiques tentent d'accaparer du pouvoir commercial en déplaçant de plus en plus de contrôle vers du logiciel gravé dans la carte-mère, c-à-d en déplaçant les fonctions du SE de la partie "Mémoire" vers la partie "Processeur" dans le schéma ci-dessus. Ce faisant, les fabricant réduisent dangereusement le contrôle que peut exercer l'utilisateur sur son ordinateur via le SE. Ils se justifient en arguant que cela augmenterait la sécurité de l'ordinateur ...
- approfondir : /informatique-libre#logiciel-materiel-donnees
- réagir : /informatique-libre#action-citoyenne
https://linux-debian.net/citoyennete-numerique#menace-informatique-libre
Algorithme
Un algorithme est un ensemble d'instructions permettant de réaliser un objectif c-à-d résoudre un problème.
Principes élémentaires de la résolution de problèmes :
- États : situation actuelle du système ou du problème (notamment variables globales et locales).
- Entrées et sorties : entrées ⇒ traitement ⇒ sorties :
- entrées : état de départ du système ou des données ;
- sorties : état souhaité ou la solution du problème ;
- fonctions ...
Règles : conditions et contraintes à respecter ⇒ l'espace des états (leur nombre) est limité.
Modélisation : il s'agit de décomposer le problème en modules (abstraction), généralement sous forme de graphes (par exemple un arbre de décision), dont les noeuds sont les états, et les liens entre eux sont les transitions d'états (PS : le nombre et la structure des noeuds est déterminée par l'énoncé et les règles qu'il induit). À chaque noeud une valeur est attribuable.
Traitement : la résolution du problème consiste alors à identifier parmi les transitions d'état le chemin qui conduit à l'état final dont la valeur est la plus élevée (gain) ou la plus basse (coût). L'algorithme permet d'automatiser ce travail au moyen de diverses opérations informatiques :
- conditions (if/else) ;
- boucles (for/while) ;
- fonctions ...
Exemple : algorithme Minimax.
- Approches :
déterministe : les mêmes entrées produisent toujours les mêmes sorties (typiquement le cas de l'IA symbolique).
heuristique : lorsque le nombre d'états est trop élevé par rapport aux capacités de calcul disponible, on peut réduire l'espace des états au moyen de règles empiriques ou d'approximations, et ainsi obtenir rapidement des solutions "assez bonnes" ;
- probabiliste lorsque les transitions entre états ne sont pas déterministes, ou lorsque les informations sur les états/transitions ne sont pas parfaites.
Les algorithme de résolution de problèmes complexes c-à-d à grand nombre de variables (états, noeuds) et à relations (transitions d'état) non déterministes devront combiner les approches heuristique et probabilistes.
De nombreux problèmes peuvent être formulés comme des problèmes de recherche ou encore de planification.
Souvent, il existe de nombreuses manières de résoudre un problème, certaines pouvant être préférables en termes de temps, d’effort, de coût ou d’autres critères. Différentes techniques de recherche peuvent aboutir à des solutions différentes.
On peut également classer les problèmes selon leur type, comme par exemple :
- la recherche et la planification en milieu statique, avec un seul «agent» ;
- les jeux à deux joueurs («agents») en concurrence l’un avec l’autre.
L'algorithme Minimax, correspond aux jeux déterministes (pas d'éléments de hasard, tels qu'un lancé de dé), à deux joueurs, à information parfaite (à tout moment, les deux joueurs connaissent complètement l'état du jeu, il n'y a pas d'informations cachées ou secrètes (comme dans le poker, où les cartes des adversaires sont cachées) et à somme nulle (le gain d'un joueur correspond exactement à la perte de l'autre, contrairement au dilemme du prisonnier).
Comme le dit fort bien Laurent Bloch, « un programme est un texte qui décrit les opérations qui mènent des données aux résultats. La programmation est proprement magique : il suffit de soumettre ces phrases à l'ordinateur pour qu'elles déclenchent des actions. Ains, dire c'est faire, ce qui relève d'un pouvoir divin » [source].
L'admiration de Bloch pour l'automatisation date d'avant l'IA telle que nous la connaissons depuis 2023. Celle-ci a depuis atteint rapidement un niveau d'autonomisation qui suscite l'inquiétude.
Faut-il s'en étonner, alors que la boucle de rétroaction qui semble décrire le fonctionnement cognitif d'un individu relativement à son environnement ressemble fichtrement à un simple algorithme ? :
- 1. Observer & chercher →
- 2. Décider (raisonnement "quoi") →
- 3. Agir (raisonnement "comment") → retour à 1
- Perception →
- Mémoire →
- Hypothèse →
- Prédiction →
- Action →
- Conséquence →
- Apprentissage → retour à 1
Dans les sections suivantes, nous allons progressivement avancer dans la compréhension de cette problématique.
IA symbolique
L'IA "symbolique", développée dans les années 1980, est caractérisée par l’utilisation de règles logiques pour résoudre des problèmes, simulant un raisonnement déductif (exemple : si..., alors...). Elle est peu performante dans les problématiques instables et ouvertes.
Pour reprendre les notions du triangle sémiotique de la linguistique (signifiant, signifié, objet : source), « l’IA symbolique ne dispose que du signifiant auquel elle associe éventuellement un objet mais elle est incapable de prendre en considération le signifié du mot, les concepts lui restent totalement étrangers, aussi, elle manipule les symboles sans avoir aucune idée de ce qu’ils sont, sans les comprendre pourrait-on dire » [source].
Réseau physique
Après que l'IA symbolique eut atteint son apogée dans les années 1980, le développement d'Internet à partir des années 1990 va donner accès à des quantités gigantesques de données. D'autre part, pendant ces deux décennies, la capacité de calcul des processeurs a augmenté exponentiellement. Suite à ces deux évolutions, tout était en place dès les années 2010 pour que l'IA connexionniste, née avec l'IA symbolique dans les années 50, prenne la première place.
Et l'IA connexionniste est fondée sur la notion de probabilité ...
IA et statistique
2. Probabilité conditionnelle
3. Optimisation par recuit simulé
4. Régression linéaire
5. Méthode du plus proche voisin
6. Optimisation de modèle
7. Régression logistique
L'apport des probabilités à l'IA
Les méthodes statistiques permettent d’étendre l’intelligence artificielle (IA) à :
- des problématiques complexes, c’est-à-dire lorsque les variables sont nombreuses et que leurs relations ne sont pas entièrement déterministes ;
- la gestion de l’incertitude, lorsque l’information disponible est imparfaite (incomplète ou erronée).
Pour ce faire, la statistique utilise des outils mathématiques pour extraire de l’information à partir d’échantillons et de quantifier l’incertitude, ce qui est essentiel pour construire des algorithmes d’apprentissage automatique (machine learning). Ainsi l’IA repose largement sur des modèles statistiques pour apprendre à partir de données, identifier des tendances et faire des prédictions.
Il existe de nombreuses méthodes d'IA selon le type de fonction cognitive que l'on souhaite simuler. Ainsi la régression permet de prédire une valeur continue comme par exemple le prix d'une maison, tandis que dans la classification, le résultat est une étiquette choisie parmi un ensemble fini d'alternatives, par exemple malade ou en bonne santé.
Probabilité conditionnelle
Or on peut utiliser les probabilités pour raisonner, c'est-à-dire pour déduire une chose d'une autre. Cela est basé sur la probabilité conditionnelle, c-à-d la probabilité que se produise l'événement A lorsque l'événement B s'est produit (ou que A soit vrai lorsque B l'est aussi). Autrement dit, P(A|B) = x % signifie que x % des événements où B est vrai vérifient également A [source].
Une méthode pour comprendre intuitivement la signification de la probabilité conditionnelle consiste à utiliser la notion d'ensembles : la probabilité d'être à la fois dans les ensembles A et B, c'est la probabilité d'être dans l'ensemble A fois la probabilité d'être dans l'ensemble B étant donné qu'on est déjà dans l'ensemble A :
P(A∩B) = P(A) * P(B|A) ⇔
P(B|A) = P(A∩B) / P(A) ⇔
P(B|A) = P(B∩A) / P(A)
Interprétation : la probabilité de B étant donné A c'est la probabilité de A et B divisée par la probabilité de A.
Une autre approche intuitive consiste à montrer que la probabilité conditionnelle permet d'exprimer une probabilité simple P(A) comme une moyenne de probabilités conditionnelles P(A∣Bi), pondérées par les probabilités des conditions P(Bi), qui forment une partition (somme égale à 1) : soit P(S) la proportion d'étudiant qui réussissent leur examen (S pour "succès"), P(R) la proportion d'étudiant ayant révisé, et R− l'événement "pas de révision" ⇒ :
P(S) = P(S|R) * P(R) + P(S|R−) * P(R−)
Interprétation : la proportion d'étudiants qui réussissent c'est la proportion de ceux qui ont révisé, pondérée par la probabilité de réussir étant donné qu'on a révisé, plus la proportion de ceux qui n'ont pas révisé, pondérée par la probabilité de réussir étant donné qu'on a pas révisé.
Le théorème de Bayes exprime P(A|B) comme fonction de P(B|A), P(A) et P(B) : P(A|B) = P(B|A) * P(A) / P(B) . Nombreux sont les étudiants qui ne le comprennent pas intuitivement car nombreux sont les manuels de statistiques qui ne prennent pas le temps d'expliquer comment on arrive à cette formule. Nous allons tenter ici d'y remédier.
de Bayes
L'objectif initial est de mettre à jour la probabilité d'un événement A en tenant compte d'une nouvelle information P(B) (ce que certains scientifiques appellent abusivement "prédire A"). On veut donc trouver une fonction F telle que P(A)post = F[ P(B) ] et que l'on va noter P(A|B). Mais pour ce faire, il est plus intuitif de commencer par raisonner en terme de cote plutôt que de probabilité :
- Probabilité(A) = #A / ( #A + #B )
où B = A− - Cote(A) = #A / #B
Proportion et probabilité
Si on lance une pièce de monnaie 100 fois et qu'on obtient 55 fois "pile", la proportion observée (ou fréquence observée) de "pile" est 55/100=0,55.
La probabilité théorique d'obtenir "pile" avec une pièce équilibrée est 0,50 même si les observations ne correspondent pas exactement à cette valeur.
La loi des grands nombres établit un lien entre probabilité et proportion : lorsque le nombre d'observations tend vers l'infini, la proportion observée converge vers la probabilité théorique.
Il est facile de montrer que la cote d'un événement c'est le ratio entre la probabilité que l'événement se produise et la probabilité qu'il ne se produise pas :
#A / #B =
[ #A / ( #A + #B ) ] / [ #B / ( #A + #B ) ] =
P(A) / P(A−) =
P(A) / ( 1 - P(A) )
Soit B l'événement observé pour mettre à jour P(A) ⇒
- B|A est appelé "test vrai positif" ;
- B|A− est appelé "test faux positif" ;
- RV = P(B|A) / P(B|A−) est appelé "ratio de vraisemblance de A".
Soit Cant. la cote de A antérieure à l'obtention de l'information P(B), alors la cote de A postérieure :
Cpost. = Cant. * RV ⇔
P(A|B) / ( 1 - P(A|B) ) = P(A) / ( 1 - P(A) ) * P(B|A) / P(B|A−) ⇔
P(A|B) = P(B|A) * P(A) * ( 1 - P(A|B) ) / ( 1 - P(A) ) / P(B|A−) ⇔
P(A|B) = P(B|A) * P(A) * ( 1 - P(A|B) ) / ( 1 - P(A) ) * P(A−) / P(B∩A−) ⇔
P(A|B) = P(B|A) * P(A) * ( 1 - P(A|B) ) / P(B∩A−) ⇔
P(A|B) = P(B|A) * P(A) * ( 1 - P(A|B) ) / P(A−∩B) ⇔
P(A|B) = P(B|A) * P(A) * ( 1 - P(A|B) ) / P(B) / P(A−|B) ⇔
P(A|B) = P(B|A) * P(A) / P(B)
qui est la formulation traditionnelle du théorème de Bayes.
Interprétation. B peut être le test sérologique attestant d'une probable infection, ou encore la présence de nuages dans le ciel le matin, présageant d'une possible journée pluvieuse. Mais B ne garantit pas la certitude : il peut y avoir des nuages sans pluie, et un test peut être positif malgré l'absence d'infection (faux positif). Le théorème de Bayes permet de quantifier la variation d'incertitude concernant l'événement A, suite à l'information apportée par l'événement B, en multipliant la cote antérieure de A par le rapport entre la probabilité de vrai positif P(B|A) et probabilité de faux positif P(B|A−) .
La qualité de l'information apportée par le théorème de bayes est dépendante de la mesure dans laquelle la cote antérieure décrit la réalité ...
Application. La règle de Bayes peut être utilisée pour concevoir un filtre qui trie les emails reçus (pour les envoyer soit dans la boîte "Réception" soit dans la boîte "Pourriel") en identifiant des caractéristiques typiques des spams (notamment, ils comprennent souvent le mot "acheter"). Il suffit de calculer les rapports de vraisemblance des principaux mots d'un message, puis de les multiplier à la cote antérieure (par exemple 1:1) : la cote postérieure, après un premier mot, devient la cote antérieure pour le mot suivant, et ainsi de suite. Il suffit alors de déterminer un pourcentage au-delà duquel la cote postérieure classe un message comme spam ("dans x% des cas, un message contenant ces mots est un spam") [source].
PS : maintenant vous comprenez pourquoi il arrive régulièrement que des courriels sont classés par erreur comme spams ...
Optimisation par recuit simulé
Pour illustrer la notion d'optimisation, ainsi que la méthode du recuit simulé, imaginons que notre objectif est de secouer la surface bosselée du schéma ci-dessous de sorte que la balle située dans l'optimum local D (un creux mais pas le plus bas) se retrouve dans l'optimum global B (le creux le plus bas)..
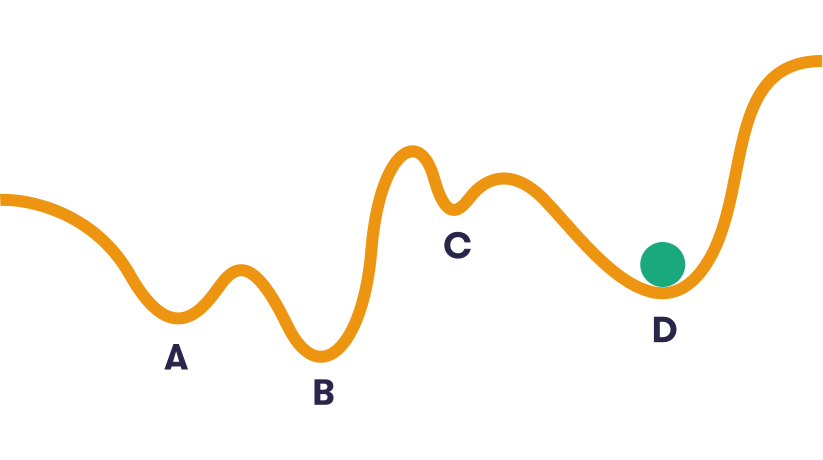
Si vous secouez doucement la surface, il est peu probable que la balle s'échappe de sa position initiale D. Si vous donnez à la surface une seule secousse très forte, la balle rebondira de manière aléatoire puis roulera en bas de la colline jusqu'à un optimum local qui peut ou non être l'optimum global B.
La stratégie de secousse la plus rationnelle pour faire atterrir la balle au point le plus bas B, consiste à secouer la surface de façon continue mais avec une force décroissante. En commençant par de fortes secousses, la balle rebondira d'abord de manière aléatoire, mais ensuite, à mesure que vous réduirez la force, plus la position de la balle sera basse, moins il sera probable qu'elle rebondisse au-dessus des « barrières » élevées autour des optima locaux.
Notez que dans l'exercice ci-dessus, l'optimum est de type minimal, mais on pourrait imaginer un exercice où l'objectif est d'atteindre le maximum global. Supposez que la boule soit un randonneur situé dans n'importe lequel des minima locaux, dont la vue des sommets lui est cachée, et qui peut juste choisie de grimper vers la gauche ou vers la droite. Et bien la méthode du recuit simulé propose une règle permettant d'atteindre le sommet le plus élevé ... avec une probabilité "acceptable".
La méthode du recuit simulé est remarquablement simple. Au lieu d'autoriser uniquement les changements qui améliorent la solution (le randonneur monte vers un sommet), certains changements qui la dégradent (descente vers un creux) sont également autorisés avec une certaine probabilité. L'acceptation d'un « mauvais » état permet alors d'explorer une plus grande partie de l'espace des états et tend à éviter de se contenter d'un optimum qui n'est que local.
Mathématiquement, la méthode consiste à sélectionner chronologiquement des valeurs St selon la règle P ≤ exp( (St - St-1) / T ) où
- St - St-1 est le pas de chaque étape ;
- T est la "température", comprise entre 1 et 0, commence à T=1 et diminue à chaque étape, par exemple selon la règle Ti+1 = λ * Ti avec λ < 1 (par exemple λ=0.99) ;
- P est la probabilité d'accepter une St inférieure à St-1.
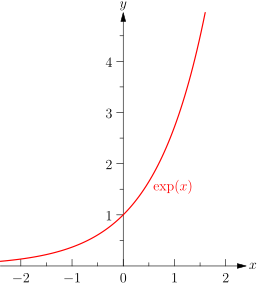
Fonction exponentielle [source].
La probabilité d'autoriser une transition vers le bas dépend donc de deux choses : la quantité de descente (la différence avec la position précédente retenue) et ce que l'on appelle une « température ». Ainsi lorsque lorsque St < St-1) ⇔ St - St-1 < 0) ⇒ plus ( St - St-1 ) / T diminue avec T ⇒ moins on acceptera un St inférieur. L'idée est de commencer à une température élevée pour que les changements soient plus ou moins aléatoires, mais de diminuer progressivement la température pour qu'à terme, la probabilité de descendre devienne infime.
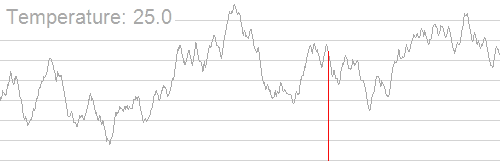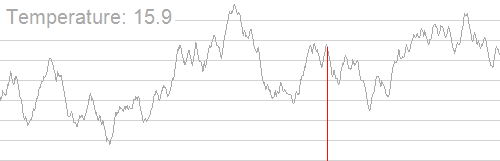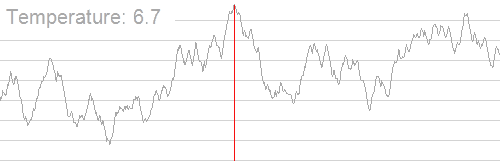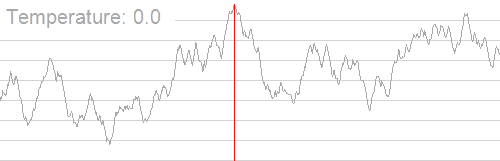
Ainsi l'animation suivante montre qu'à des températures élevées, l'optimum global peut-être atteint mais que l'on y reste pas, tandis que plus la température est basse moins il est probable d'échapper à l'optimum global lorsqu'on s'en est approché.
Régression linéaire
La régression linéaire peut être utilisée pour "prédire" (évaluer), par exemple, le prix d'une maison (y) à partir d'un nombre limité d'observations : superficie (x0), et distance au plus proche voisin (x1) :
x = [95, 15]
c = [3000, 100]
y = c[0]*x[0] + c[1]*x[1]
print(y)
# Résultat :
# 286500
On comprend intuitivement que le travail de conception du modèle – c-à-d d'apprentissage, dans le cas où cette conception est réalisée par IA – consiste en l'identification pertinente des variables explicatives xi et de leur coefficient ci.
Pour estimer les ci, il nous faut une série de yj pour des xij correspondants. Vu qu'un modèle ne reproduit que partiellement la complexité de la réalité, deux maisons (réelles) qui correspondent à une même série d'input xi pourront avoir deux prix observés différents. Ou encore, même si le prix augmente généralement avec la superficie, il peut arriver qu'une surface plus grande correspond à un prix inférieur malgré que les autres variables explicatives du modèle sont identiques.
Il existe plusieurs raisons pour lesquelles les modèles ne capturent généralement pas parfaitement le phénomène sous-jacent :
- bruit : perturbations aléatoires et non systématiques ;
- variables confondantes : caractéristiques associées à la fois aux entrées et aux sorties ;
- biais de sélection : certains points de données sont plus susceptibles de se retrouver dans les données utilisées pour construire le modèle que d'autres.
Cela nécessite de comprendre le contexte dans lequel le modèle est utilisé et les biais possibles dans les données !
L'estimation des paramètres dans la régression linéaire est l'un des problèmes classiques des statistiques et de l'apprentissage automatique, et la solution la plus classique à ce problème classique est la méthode dite des moindres carrés proposée par Legendre et Gauss au début des années 1800. La raison pour laquelle cette méthode est appelée "moindres carrés" est qu'elle consiste à sélectionner la série de coefficients qui minimise les différences au carré entre valeurs calculées vs observées de la variable de sortie du modèle.
Et pour ce faire l'utilisation de matrices est très pratique, et d'autant plus que le module numpy de Python réduit le travail à une douzaine de lignes :
import numpy as np
x = np.array([
   [25, 2, 50, 1, 500],
   [39, 3, 10, 1, 1000],
   [13, 2, 13, 1, 1000],
   [82, 5, 20, 2, 120],
   [130, 6, 10, 2, 600]
])
y = np.array([127900, 222100, 143750, 268000, 460700])
c = np.linalg.lstsq(x, y, rcond=None)[0]
np.set_printoptions(precision=1)
print(c)
print(x @ c)
# Résultat :
# [3000.  200.  -50. 5000.  100.]
# [127900. 222100. 143750. 268000. 460700.]
Le code ci-dessus est l'occasion de préciser des notions très importante de modélisation, celles de variables explicatives vs dépendante, et de valeurs observées vs calculées : la matrice x montre que le modèle est composé de 5 variables explicatives (les colonnes) et de 5 séries de valeurs observées de ces variables explicatives (les lignes). La longueur de la matrice des valeurs calculées de la variable dépendante y est évidemment égale au nombre de lignes de la matrice x.
En anglais, et dans le contexte des modèles d'IA, les variables explicatives sont généralement appelées "input" (ou encore "features" et "predictors") et la variable dépendante "output" (ou encore "targets").
On notera que les valeurs calculées correspondent exactement à celles observées. Le lecteur est invité à vérifier dans sa console que cela est toujours le cas tant que le nombre de séries observées est inférieur ou égal au nombre de variables qui les composent (autrement dit, tant que le nombre de lignes de la matrice x est ≤ au nombre de ses colonnes).
numpy.linalg.LinAlgError: Incompatible dimensionspuisque les valeurs de y sont les combinaisons linéaires de x @ c ⇔ le nombre de ligne de x c'est le nombre de "colonnes" de y.
du modèle
L'optimisation d'un modèle vise à ce qu'il "généralise bien". Un modèle généralise bien lorsque sa précision (pourcentage de prédictions correctes) n'est pas substantiellement modifiée par son application à des données nouvelles (données de test). Si elle est substantiellement réduite, il faut à nouveau optimiser le modèle.
En augmentant le nombre de cas observés (lignes de x), on peut obtenir plus d'information sur la distribution réelle des données. Ces informations permettrons d'adapter la valeur des coefficients, et éventuellement d'ajouter ou retirer des variables explicatives, pour optimiser le modèle.
Avant de développer cette notion d'optimisation, illustrons comment procéder pour importer des données dans un modèle. Vous pouvez lire un fichier CSV (un format standard pour les données tabulaires) avec la fonction np.genfromtxt(datafile, skip_header=1). Cela renverra un tableau numpy qui contient la matrice x dans les colonnes précédant la dernière, et les données de la variable dépendante dans la dernière colonne.
# Importation module Python :
import numpy as np

# Importation fichier données entraînement :
input_file = "input_file.csv"

# Contenu input_file.csv :
# x1 x2 x3 x4 x5 y
# 25 2 50 1 500 127900
# 39 3 10 1 1000 222100
# 13 2 13 1 1000 143750
# 82 5 20 2 120 268000
# 130 6 10 2 600 460700
# 115 6 10 1 550 407000

# Lecture données entraînement :
data = np.genfromtxt(input_file, skip_header=1)
x = data[:, :-1]  # Toutes les colonnes sauf la dernière
y = data[:, -1]   # Dernière colonne

# Calcul coefficients :
c = np.linalg.lstsq(x, y, rcond=None)[0]

# Affichage résultats :
np.set_printoptions(precision=1)   # Ajustement précision virgule pour lisibilité :
print(c)
print(x @ c)

# Résultat :
# [2989.6  800.6  -44.8 3890.8   99.8]
# [127907.6 222269.8 143604.5 268017.6 460686.6 406959.9]
Maintenant que nous savons comment ajouter des données à notre modèle pour l'optimiser, précisons ce que l'on entend pratiquement par "optimiser un modèle" : il s'agit de maximiser sa précision, ce qui requiert de mesurer celle-ci.
On mesure la précision du modèle en comparant les valeurs calculées de la variable dépendante y à celles observées, et cela à partir de deux types d'échantillons de valeurs observées des variables explicatives :
échantillon d'entraînement (matrice x_train ci-dessous), à partir duquel les coefficients sont optimisés (par exemple par la méthode des moindres carrés) ;
échantillon de test (matrice x_test ci-dessous), différent des données d'entraînement, et dont la comparaison des valeurs observées de la variable dépendante avec les valeurs calculées de cette dernière permet de mesurer la précision du modèle.
# Importation modules Python :
import numpy as np

# Importation fichiers données :
train_file = "train_file.csv"
test_file = "test_file.csv"

# Contenu train_file.csv :
# x1 x2 x3 x4 x5 y
# 25 2 50 1 500 127900
# 39 3 10 1 1000 222100
# 13 2 13 1 1000 143750
# 82 5 20 2 120 268000
# 130 6 10 2 600 460700
# 115 6 10 1 550 407000

# Contenu test_file.csv :
# x1 x2 x3 x4 x5 y
# 36 3 15 1 850 196000
# 75 5 18 2 540 290000

# Lecture données entraînement :
train_data = np.genfromtxt(train_file, skip_header=1)
x_train = train_data[:, :-1]
y_train = train_data[:, -1]

# Calcul coefficients :
c = np.linalg.lstsq(x_train, y_train, rcond=None)[0]

# Lecture données test :
test_data = np.genfromtxt(test_file, skip_header=1)
x_test = test_data[:, :-1]

# Affichage résultats :
np.set_printoptions(precision=1) # Ajustement précision virgule pour lisibilité
print(c)
print(x_test @ c)

# Résultat:
# [2989.6  800.6  -44.8 3890.8   99.8]
# [198102.4 289108.3]
Exercice. Remplacez une série de test par une série d'entraînement : l'ouput correspondant est-il alors différent de l'output observé ?
Comme son nom l'indique, la régression linéaire n'est pas adaptée pour modéliser des phénomènes non linéaires. Il existe heureusement des modèles de régression non linéaire (polynomiale, exponentielle, spline, réseaux de neurones, etc.), mais une solution plus simple peut s'avérer satisfaisante dans certains cas : la méthode du plus proche voisin, qui ne fait aucune hypothèse forte sur la forme de la relation entre les variables (pas de fonction explicite ⇒ pas de paramètres à estimer, sauf un "hyperparamètre" : le nombre de voisins pris en compte).
Méthode du plus proche voisin
Cette méthode est basée sur la proximité des observations dans l'espace des caractéristiques. Pour une nouvelle donnée, la méthode trouve les k points les plus proches dans l’ensemble d’apprentissage, et attribue à cette donnée :
- en classification (variable dépendante catégorielle) : leur classe majoritaire ;
- en régression (variable dépendante numérique) : leur moyenne ou médiane.
Variables catégorielles
Une variable catégorielle prend un nombre fini de valeurs distinctes représentant des catégories ou des groupes :
- nominales (pas d'ordre entre les catégories) ; exemples :
- couleur : {Rouge, Bleu, Vert}
- type de véhicule : {Voiture, Moto, Camion}
- ordinales (ordre entre les catégories) ; exemples :
- taille de vêtement : {S, M, L, XL}
- niveau d’éducation : {Primaire, Secondaire, Universitaire}
Remarques :
- Une catégorie correspond à un type de relation entre les valeurs.
Certaines variables catégoriques peuvent être encodées numériquement (ex. : S=1, M=2, L=3) mais restent catégoriques car elles représentent des groupes et non des quantités mesurables.
La vectorisation permet de transformer des variables catégorielles en représentations numériques, et d'ainsi quantifier la proximité sémantique d’un objet (une variable) par rapport à un autre.
"Chat" ⇒ [1, 0, 0]
"Chien" ⇒ [0, 1, 0]
"Oiseau" ⇒ [0, 0, 1]
Chaque vecteur indique la présence (1) ou l'absence (0) de la catégorie correspondante.
import pandas as pd
data = {'animal': ['Chat', 'Chien', 'Oiseau', 'Chien', 'Chat']}
df = pd.DataFrame(data)
df_vec = pd.get_dummies(df, columns=['animal'])
print("Données initiales :",df)
print("\nDonnées après One-Hot Encoding :",df_vec)
# Résultats :
# Données initiales :
#    animal
# 0    Chat
# 1   Chien
# 2  Oiseau
# 3   Chien
# 4    Chat
# Données après One-Hot Encoding :
#    animal_Chat  animal_Chien  animal_Oiseau
# 0            1             0              0
# 1            0             1              0
# 2            0             0              1
# 3            0             1              0
# 4            1             0              0
Ainsi, en exprimant les localisations dans un système de coordonnées cartésiennes, le théorème de Pythagore nous dit que les distances peuvent alors être calculées en additionnant les carrés des différences entre les coordonnées x et y, et en prenant la racine carrée de la somme :
DA,B = √ [ (xA−xB)2+(yA−yB)2 ] (distance euclidienne)
En Python :
D = math.sqrt((x_A−x_B)**2 + (y_A−y_B)**2)
Distance euclidienne
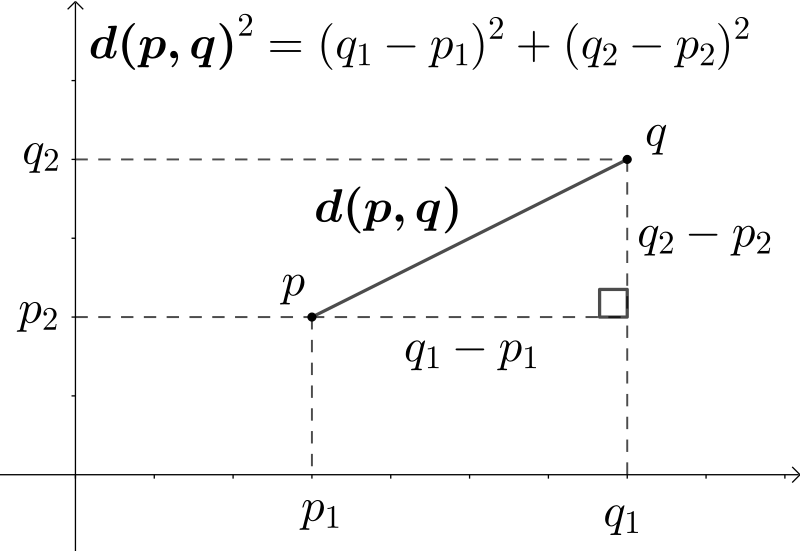
De la même manière, nous pourrions calculer la différence ou la « distance » entre la maison 1 (surface=3434 m2, distanceVoisin=10 m) et la maison 2 (surface=4949 m2, distanceVoisin=50 m) en considérant les deux variables explicatives comme les "coordonnées" des maisons :
DA,B = √ [ (34−49)2+(10−50)2 ] (distance euclidienne)
En Python :
x1 = [34.0, 10.0]
x2 = [49.0, 50.0]
D = math.sqrt((x1[0] - x2[0])**2 + (x1[1] - x2[1])**2)
Mathématiquement, chaque série de variables explicatives xi est un vecteur. En termes de codage, ce sont des listes ou des tableaux unidimensionnels.
La méthode du plus proche voisin fournit ainsi une technique de prédiction qui n'est pas fondée sur la régression linéaire. Ainsi dans l'algorithme suivant, le prix des deux séries de test n'est pas calculé par régression linéaire (NB : aucun coefficient n'est mentionné), mais en identifiant la série de l'échantillon d'entraînement dont chacune de ces deux série de test est la plus proche. La valeur observée de la variable dépendante lui est alors attribuée.
Les fonctions spécifiques de la bibliothèque numpy nous permettent de faire tout cela en quelques lignes de code.
import math
import numpy as np
x_train = np.array([
    [25, 2, 50, 1, 500],
    [39, 3, 10, 1, 1000],
    [82, 5, 20, 2, 120],
    [130, 6, 10, 2, 600]])
y_train = [127900, 222100,  268000, 460700]
x_test = np.array([
    [115, 6, 10, 1, 560],
    [13, 2, 13, 1, 1000]])
for test_item in x_test:
    distances = np.sum((x_train - test_item) ** 2, axis=1)
    nearest_index = np.argmin(distances)
    print(y_train[nearest_index])
# Résultat :
# 460700
# 222100
Optimisation du code. À la ligne 5 on ne calcule même pas la racine carrée car, étant une fonction monotone, elle ne change pas le résultat de la sélection de la valeur minimale, opérée à la ligne suivante. On réduit ainsi le temps de calcul, ce qui peu s'avérer utile lorsque la dimension du tableau x_train dépasse une certaine taille.
- Pour tester ou expliquer du code il peut-être plus simple de simuler l'importation de données :
x_train = np.random.rand(4, 5)
x_test = np.random.rand(5)
PS : on aura évidemment un résultat différent à chaque exécution du code puisque les données sont aléatoires.
À priori, le résultat (1) apparaît de façon intuitive en comparant x_test à la seconde ligne de x_train : les variables explicatives sont effectivement assez proches (N.B. : l'indice 1 correspond bien au second élément car en informatique l'indexation commence à partir de zéro).
Cependant, la pertinence de notre algorithme de sélection est critiquable en termes économiques : si l'on trouvait une maison correspondant à la maison test son prix serait probablement plus proche de la première maison, car leurs surfaces sont plus proches, et la surface est la variable explicative principale dans le prix d'une maison. Le résultat de notre algorithme illustre une limitation de la distance euclidienne : alors que le premier critère (surface) varie entre 13 et 130, le dernier varie entre 120 et 1000, de sorte que celui-ci va être surdéterminant mathématiquement alors qu'il est peut-être le moins déterminant économiquement. Autrement dit une différence de 100 m entre les distances au voisin est relativement moins importante qu'un différence de 100 m2 entre les surfaces (et c'est sans parler des différences induite par les unités utilisées, par exemple des pieds au lieu de mètre dans les pays anglo-saxons). Le fait que les variables explicatives utilisent la même échelle biaise donc le résultat de l'algorithme.
Quelques solutions pour neutraliser cette limitation de la distance euclidienne :
utiliser la distance de Manhattan d(A,B)= ∑|Ai−Bi| plutôt que la distance euclidienne d(A,B)= √ [ ∑(Ai−Bi)2 ], afin de réduire l'ampleur du biais ;
mettre les valeurs des données d'entraînement à la même échelle (normalisation) de manière à ce qu’elles aient le même poids dans le calcul de la "distance".
MinMaxScaler est un outil Python de prétraitement, pour mettre à l'échelle les données dans une plage spécifique (par exemple, entre 0 et 1).
de langage
Les modèles de langage naturel mesurent la "distance" entre deux phrases : il s'agit d'identifier parmi un échantillon de phrases d'entraînement celle dont une phrase de test est la plus proche. sur base du nombre d'occurrences des mots. Pour vectoriser un phrase, une méthode consiste à calculer la fréquence de ses mots (ceux-ci jouent donc le rôle des variables explicatives utilisées pour déterminer le prix d'une maison). En effet, ce qui distingue une phrase parmi d'autres, ce sont souvent les mots qui y sont les fréquents, mais rares dans les autres phrases.
Plus précisément, la valeur d'un mot serait sa fréquence dans une phrase, relativement à sa fréquence dans le texte constitué par les phrases. Une méthode pour ce faire est TF-IDF ("term frequency-inverse document frequency"), qui consiste à appliquer plus de poids aux mots moins fréquent selon la règle : poids = ft × log(1/fd) où:
- fréquence du terme (ft) : nombre d'occurrences divisé par la longueur du document ;
- fréquence du document (fd) : nombre de documents dans lesquels chaque mot apparaît, divisé par le nombre total de documents.
Humpty Dumpty sat on a wall
Humpty Dumpty had a great fall
all the king's horses and all the king's men
couldn't put Humpty together again
L'algorithme suivant calcule la distance (de Manhattan) la plus proche entre des séries de mots (les phrases) dont les valeurs sont les fréquences tf-idf des mots qui les constituent.
N.B. Dans la terminologie tf-idf, chaque phrase est un "document", et leur ensemble est appelé "corpus".
import numpy as np
import math

text = '''Humpty Dumpty sat on a wall
Humpty Dumpty had a great fall
all the king's horses and all the king's men
couldn't put Humpty together again'''

def main(text):
    # 1. Séparer texte en documents (lignes) et convertir les mots en minuscules :
    docs = [line.lower().split() for line in text.split('\n')]
    N = len(docs)  # Nombre total de documents

    # 2. Liste des mots du corpus :
    vocabulary = list(set(word for doc in docs for word in doc))

    # 3. Calculer la fréquence des termes (TF) et la fréquence des documents (DF)
    tf = {}  # Une liste par document
    df = {}  # Une liste par document

    for word in vocabulary:
        tf[word] = [doc.count(word) / len(doc) for doc in docs]
        df[word] = sum(1 for doc in docs if word in doc) / N

    # 4. Construire la représentation TF-IDF pour chaque document :
    tfidf_vectors = []
    for doc_index in range(N):
        vector = []
        for word in vocabulary:
            idf = math.log(1 / df[word], 10)
            tfidf_value = tf[word][doc_index] * idf
            vector.append(tfidf_value)
        # Arrondir chaque valeur du vecteur TF-IDF à trois décimales :
        tfidf_vectors.append([round(x, 3) for x in vector])

    # 5. Créer une matrice pour stocker les distances entre les documents :
    dist = np.empty((N, N), dtype=float)

    # Calcul distance Manhattan :
    for i in range(N):
        for j in range(N):
            if i == j:
                dist[i, j] = np.inf  # Ignorer la comparaison d'un document avec lui-même
            else:
                diff = [abs(a - b) for a, b in zip(tfidf_vectors[i], tfidf_vectors[j])]
                dist[i, j] = sum(diff)

    # 6. Trouver la paire de documents la plus similaire (distance minimale) :
    nearest_pair = np.unravel_index(np.argmin(dist), dist.shape)

    # Afficher les vecteurs TF-IDF (arrondis) pour chaque document :
    print("Vecteurs TF-IDF :")
    for idx, vec in enumerate(tfidf_vectors):
        print(f"Document {idx}: {vec}")

    # Afficher la paire de documents les plus similaires et leur distance arrondie
    print("\nPaire de documents les plus similaires (indices) :", nearest_pair)

main(text)
# 7. Résultat :
# Vecteurs TF-IDF :
# Document 0: [0.0, 0.0, 0.021, 0.0, 0.0, 0.0, 0.0, 0.0, 0.0, 0.1, 0.0, 0.0, 0.1, 0.05, 0.0, 0.0, 0.1, 0.0, 0.05]
# Document 1: [0.0, 0.1, 0.021, 0.0, 0.0, 0.0, 0.0, 0.0, 0.1, 0.0, 0.0, 0.0, 0.0, 0.05, 0.0, 0.0, 0.0, 0.1, 0.05]
# Document 2: [0.134, 0.0, 0.0, 0.067, 0.134, 0.0, 0.0, 0.0, 0.0, 0.0, 0.0, 0.134, 0.0, 0.0, 0.067, 0.067, 0.0, 0.0, 0.0]
# Document 3: [0.0, 0.0, 0.025, 0.0, 0.0, 0.12, 0.12, 0.12, 0.0, 0.0, 0.12, 0.0, 0.0, 0.0, 0.0, 0.0, 0.0, 0.0, 0.0]
# Paire de documents les plus similaires (indices) : (0, 1)
Commentaires :
- le résultat correspond bien à la comparaison intuitive des phrases 1 et 2 (indices 0 et 1) ;
- les vecteurs de chaque document sont bien composés des fréquences relatives des 19 mots différents composant le corpus.
Concernant unravel_index() du point 6 :
• explication intuitive
• numpy.org/unravel_index
Nous avons ainsi représenté en chiffres, sous la forme de vecteurs, des notions telles que la valeurs des composants du prix d'une maison, et le nombre des mots caractéristiques d'une phrase (ce qui permet d'approcher sa signification, ... laquelle peut encore être affinée en vectorisant les mots eux-mêmes : cf. Word2vec).
Optimisation de modèle
Un modèle évolue grâce à un entraînement qui lui permet d’être de plus en plus performant. Le principe consiste, en utilisant un jeu de données d’entraînement, à mesurer l’écart entre la réponse fournie par le modèle (variable dépendante calculée) et la réponse attendue (variable dépendant observée), et à ajuster le modèle pour minimiser cet écart (appelé "fonction de perte" ou "fonction de coût").
Les termes "ajustement/optimisation" (du modèle) – qui désignent le processus d'entraînement des modèles par minimisation (ou maximisation) d'une fonction de coût ou de perte – sont généralement remplacés par "apprentissage" (par le modèle) lorsque le processus est automatisé.
Le processus d'apprentissage, par lequel la performance d'un modèle est maximisée, est un processus d'essai-erreur visant à trouver un équilibre optimal entre deux phénomènes d'ajustement :
sur-ajustement ("overfitting") : le modèle a une précision élevée sur l'ensemble d'entraînement, mais celle-ci chute sur l'ensemble de test. Cela indique que le modèle a appris de manière trop spécifique les données d'entraînement, ce qui empêche une bonne généralisation aux données nouvelles.
Par "trop spécifique", on entend que le modèle apprend notamment des détails et les bruits des données d'entraînement. La prise en compte de détails rend le modèle trop complexe.
- Le sur-ajustement concerne également la méthode du plus proche voisin [exemple]. La fonction knn.score calcule la précision de ce type de modèle.
sous-ajustement ("underfitting") : la précision est faible tant sur l'ensemble d'entraînement que sur l'ensemble de test. Cela signifie que le modèle n'a pas appris suffisamment les motifs ou relations présentes dans la distribution réelle des données, ce qui limite sa capacité à faire des prédictions correctes.
| Entraînement | Test | |
|---|---|---|
| Sur-ajustement | Haute précision | Basse précision |
| Sous-ajustement | Basse précision | Basse précision |
Une bonne précision (petite erreur) sur l’ensemble de test est donc un indicateur d’une bonne capacité de généralisation. Cependant ce n'est pas une garantie absolue : si l’ensemble de test est trop similaire aux données d’entraînement, une faible erreur de test peut simplement indiquer que le modèle reconnaît des motifs déjà vus, sans pour autant bien généraliser à des données réellement nouvelles.
De même, une petite erreur d'entraînement ne garantit pas que le modèle prédit réellement bien les nouvelles données : Un modèle très complexe (par exemple, un réseau de neurones profond avec beaucoup de paramètres) peut surapprendre (overfitting), c'est-à-dire mémoriser les données d’entraînement sans être capable de bien prédire des données réellement nouvelles.
Seuils recommandés pour les tests de précision :
- données d'entraînement : 85-95 % ;
- données de test : 80-90 %.
Au-delà de ces pourcentages, les gains deviennent marginaux et le risque de surajustement important.
- car le modèle est conçu directement sur l'ensemble d'entraînement, il devrait donc généralement fonctionner au moins aussi bien sur ces données ;
- le surajustement entraîne souvent une précision d'entraînement supérieure à la précision de test.
Pour maximiser la performance d'un modèle (c-à-d sa précision et généralisation), on peut améliorer :
les données : les échantillons d'entraînement et de test sont-ils fiables, représentatifs et suffisamment diversifiés ... ?
La séparation des données de l'échantillon entre données d'entraînement et de test est-elle non-biaisée ? Une solution simple consiste à diviser les données en n ensembles différents et à entraîner le modèle n fois, à chaque fois avec une combinaison différente de n - 1 ensembles, l'ensemble restant étant utilisé comme ensemble de test. De cette façon, vous obtiendrez n estimations sur les performances de votre modèle sélectionné lors de l'utilisation de données non vues. C'est ce qu'on appelle la validation croisée avec omission d'un élément, et c'est l'un des moyens les plus simples de réaliser une validation croisée. La fonction python train_test_split permet de diviser un ensemble de données en sous-ensembles d'entraînement et de test.
le modèle : les variables explicatives et les hyper-paramètres (par exemple k dans la méthode des k plus proches voisins) sont-ils pertinents (en termes quantitatifs et qualitatifs).
Une technique utilisée pour empêcher le surajustement (régularisation) dans les modèles d’apprentissage automatique, en particulier les modèles d’apprentissage profond, est l'abandon ("dropout").
Un bon échantillon de test reflète fidèlement la distribution réelle, tout en contenant des exemples suffisamment nouveaux pour évaluer la robustesse et la généralisation du modèle.
Il n’existe pas de méthode précise permettant de déterminer à l’avance quelle méthode d'optimisation et quelle manière de représenter les données produiront les meilleurs résultats. Certaines méthodes d’apprentissage automatique sont bien meilleures que d’autres pour une tâche particulière. En pratique, l'optimisation de modèle est un art pragmatique qui implique beaucoup d’expérimentation et la meilleure méthode ne peut souvent être trouvée que par essais et erreurs.
Le facteur le plus important pour déterminer si une application réussira n'est souvent pas la méthode d'optimisation choisie, mais la façon dont vous l'utilisez : la quantité et la qualité des données d'entraînement, la façon dont les données sont prétraitées et représentées, la façon dont les résultats sont interprétés et appliqués, etc. Cependant, à un moment donné, les méthodes elles-mêmes peuvent devenir le facteur limitant. L'une de ces limites est la linéarité du modèle [source].
Pour modéliser une courbe en cloche, une solution consiste à prétraiter les données en découpant la fonction en segments considérés comme des relations linéaires (chacune avec coefficient propre), de sorte que la variable continue considérée devient une variable catégorielle ⇔ on obtient une fonction en escalier. Mais trouver la bonne façon de coder les données peut être un travail "manuel" fastidieux : quel est le meilleur découpage ?, davantage de paramètres dans le modèle, risque plus élevé de surajustement (à moins que nous n'ayons suffisamment de données).
Heureusement, il existe une autre voie. Si nous soupçonnons qu'il peut y avoir des propriétés non linéaires dans les données, nous pouvons également appliquer des méthodes non linéaires telles que la méthode du voisin le plus proche ou les réseaux neuronaux. Pour aborder ces notions, il nous faut passer par la régression logistique ...
Régression logistique
La régression linéaire et la méthode du plus proche voisin produisent différents types de prédictions. La régression linéaire donne des sorties numériques, tandis que le plus proche voisin produit des étiquettes à partir d’un ensemble fixe d’alternatives («classes»). Avec la régression logistique, on peut prendre la sortie de la régression linéaire, qui est un chiffre, et on prédit une étiquette A si l’étiquette est supérieure à zéro, et une étiquette B si l’étiquette est inférieure ou égale à zéro. Ainsi, au lieu de prédire simplement une classe ou une autre, la régression logistique peut aussi nous donner une mesure de l’incertitude quant à la prédiction.
Pour analyser mathématiquement la notion de régression logistique, il faut commencer par exposer la fonction logistique.
logistique
La régression logistique est la fonction logistique d'une régression linéaire, et constitue le modèle du neurone formel. Mais ne brûlons pas les étapes, et commençons par approfondir la notion de fonction logistique. Celle-ci est non linéaire, car elle ne peut pas être exprimée comme une combinaison linéaire de ses variables (sa forme n'est pas une droite).
La fonction logistique est basée sur la fonction exponentielle. Deux exemples fréquents sont :
- la fonction sigmoïde S(x) = 1 / (1 + exp(-x)) :
- produit une sortie entre 0 et 1 (ce qui permet d’interpréter cette valeur comme une probabilité) ;
- idéale pour les problèmes de classification binaire ;
- convient pour une seule sortie activée.
la fonction sofmax σ(x)j = ezj / ∑k=1K ezk : un vecteur z = ( z1 , … , zK ) est transformé en un vecteur σ(z) de K nombres réels strictement positifs et de somme 1, et tel que la composante j du vecteur σ(z) est égale à l'exponentielle de la composante j du vecteur z divisée par la somme des exponentielles de toutes les composantes de z. Il s'agit donc d'une généralisation de la fonction logistique qui :
- produit une distribution de probabilités (la somme des sorties est égale à 1). ;
- convient aux problèmes de classification multi-classes où l'on doit choisir une seule classe parmi plusieurs ;
- transforme un vecteur d'entrée en probabilités normalisées.
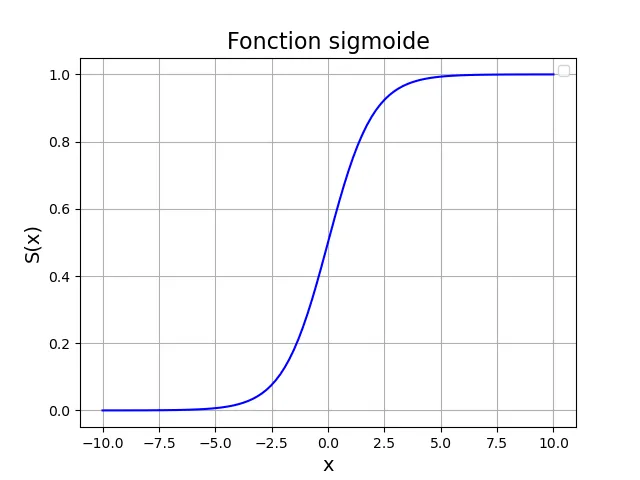
logistique
La régression logistique, fonction logistique d'une régression linéaire, constitue le modèle du neurone formel.
Avant d'entrer dans le vif du sujet, il est utile de comparer régressions linéaire et logistique afin de bien comprendre ce qu'apporte la transformation d'une combinaison linéaire des variables d'entrée en fonction non linéaire :
- régression linéaire :
- objectif : prédire une valeur continue (par exemple, un prix, une température, etc.) ;
optimisation : minimiser l'erreur quadratique (squared error), c'est-à-dire la différence au carré entre les valeurs prédites et les valeurs observées.
- régression logistique :
- objectif : prédire une probabilité (entre 0 et 1) qu'une observation appartienne à une classe donnée (par exemple, "oui" ou "non") ;
Donnée Var. explic. Probabilité Var. dép. Email 1 Contient "gagner" ? 0.9 1 (spam) Email 2 Contient "offre" ? 0.2 0 (pas spam) optimisation : maximiser la vraisemblance (likelihood) des prédictions par rapport aux réponses observées. Cela se fait en minimisant la fonction de perte logistique (log loss), qui mesure l'écart entre les probabilités prédites et les étiquettes réelles : si l'étiquette observée est de classe 1, la probabilité est directement obtenue à partir de la sortie sigmoïde ; si l'étiquette observée est de classe 0, la probabilité est obtenue à partir de un moins la sortie sigmoïde. La perte logarithmique pour un ensemble de données donné est la somme des logarithmes négatifs de ces probabilités (il existe des fonctions Python spécifiques pour la calculer et minimiser).
- objectif : prédire une probabilité (entre 0 et 1) qu'une observation appartienne à une classe donnée (par exemple, "oui" ou "non") ;
Ainsi la régression logistique est telle que :
- variables dépendantes observées (cible) : étiquettes binaires, souvent codées comme 0 (pour "non") ou 1 (pour "oui"). Par exemple, dans un modèle de prédiction de spam, "1" pourrait représenter "spam" et "0" "non-spam".
- variables dépendantes calculées : la régression logistique ne prédit pas directement une étiquette binaire, mais plutôt une probabilité (comprise entre 0 et 1) que l'observation appartienne à la classe "1" (ou "oui"). Cette probabilité est calculée à l'aide de la fonction logistique (sigmoïde) :
P(Y=1 | X) = 1 + e - (β0 + β1 * x1 + ... + β0 * x1)
où les βi xi sont les coefficients et variables indépendantes. - seuil de décision : Pour convertir cette probabilité en une prédiction binaire, on utilise généralement un seuil (par défaut 0,5). Si la probabilité est ≥ 0,5, on prédit "1" (oui), sinon on prédit "0" (non).
Réseaux de neurones artificiels
2. Réseau multicouche
3. Apprentisage automatique
4. Focus sur l'IA générative (conversationnelle)
5. L'art de la modélisation
Neurone formel
Nous venons de voir que la régression logistique, fonction logistique d'une régression linéaire, constitue le modèle du neurone formel.
Le terme "neurone" dans l'expression "neurone formel" n'est pas qu'une analogie avec le neurone biologique. Il s'agit bien d'une modélisation mathématique et informatique du neurone biologique.
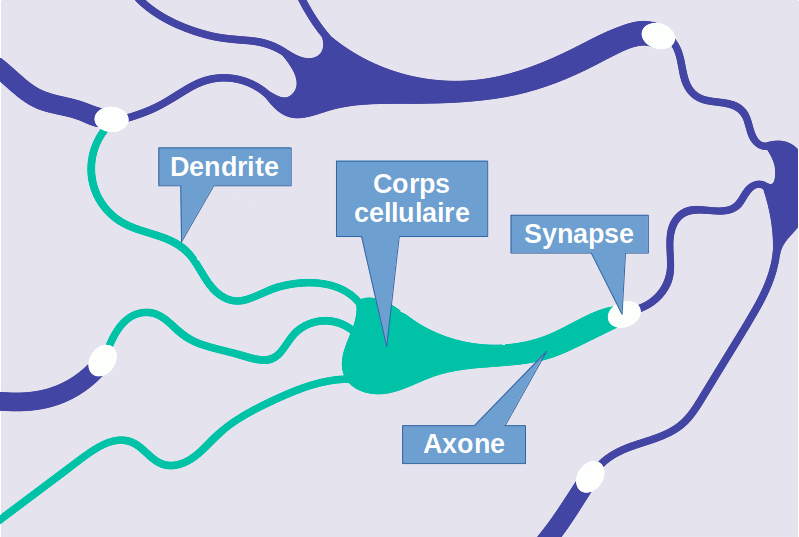
Neurone biologique
Le schéma ci-dessus montre que chaque neurone ne peut être considéré indépendamment du réseau dont il constitue un nœud. Le neurone formel exprime le fait qu'à chaque entrée d'un neurone (cf. dendrites) correspond la sortie d'un neurone "amont" (cf. axone).
Dès 1943, le neurologue Warren McCulloch et le psychologue logicien Walter Pitts, travaillant tous les deux sur l’action des neurones dans le cerveau humain, mettent au point un modèle de "réseau de neurones". L’idée est donc qu’un "neurone" artificiel ou formel pourrait accueillir des entrées provenant de neurones d’une couche précédente. Ce "neurone" ferait alors, tel un automate, la somme des entrées de la couche précédente, une somme qui serait pondérée par des "poids" (ces poids miment la plasticité synaptique des réseaux biologiques). Cette somme serait alors soumise à une fonction d’activation non linéaire qui, agissant comme un seuil franchi ou non, détermine si le neurone active ou non sa sortie – l’application de cette fonction à la somme des valeurs issues des entrées des couches précédentes permettant ou pas d’atteindre une valeur seuil donnée.
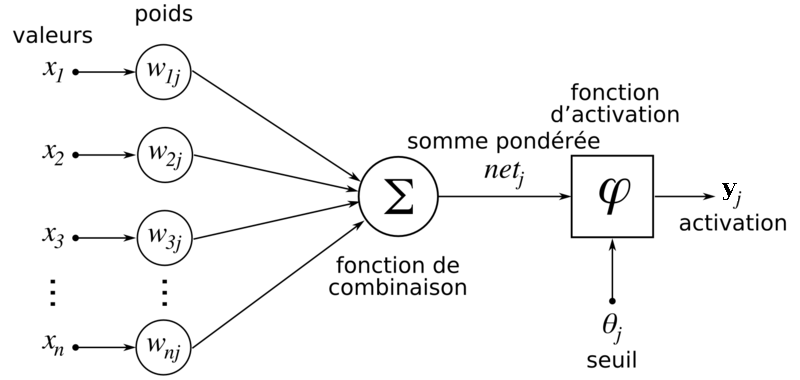
Neurone formel
Chaque neurone correspond donc à une somme pondérée, dont chaque coefficient de pondération relie une sortie de la couche précédente à une entrée de la couche suivante, de sorte que chaque variable de sortie s'exprime mathématiquement par yj = φ *( ∑i=1 n wij * xi + bj ) où :
wij : coefficients de pondération associés à la fonction yj ("poids synaptique", qui définit la force du lien entre deux neurones) ;
b : un biais, qui permet de déplacer la fonction d'activation/transfert et d'ajuster encore plus la sortie du neurone (il permet au neurone de s'activer même lorsque la somme des entrées est nulle) ;
φ() : fonction d'activation de la fonction de transfert yj (le terme "activation" est emprunté directement aux neurosciences où les neurones communiquent en envoyant des impulsions électriques à d’autres neurones lorsqu’ils sont activés par des stimuli reçus).
Par extension, le modèle de régression logistique est également celui du réseau neuronal, mais la mise en réseau des neurones, au travers de couches neuronales, induit un phénomène d'émergence par lequel le tout est plus que la somme de ses composantes.
Réseau multicouche
La régression logistique peut être vue comme un cas particulier d’un réseau de neurones à une seule couche (sans couche cachée), où une combinaison linéaire des entrées est transformée par une fonction sigmoïde ou softmax. Cependant, lorsqu’on empile plusieurs couches neuronales, on observe un phénomène d’émergence : le réseau devient capable d’apprendre des représentations hiérarchiques et abstraites des données. Ce phénomène repose sur le fait que chaque couche intermédiaire transforme et réencode l’information, permettant au réseau d’extraire progressivement des caractéristiques de plus en plus complexes.
Voici un réseau neuronal qui se compose d'une couche d'entrée avec cinq nœuds (les variables explicatives du modèle), d'une première couche cachée avec deux nœuds (le nombre de variables explicative), suivie d'une deuxième couche cachée également avec deux nœuds, et enfin d'une couche de sortie avec un seul nœud. De plus, il existe un seul nœud de biais pour chaque couche cachée et la couche de sortie (PS : le but du nœud de biais est fonctionnellement le même qu'avec le terme d'interception dans une régression linéaire : il peut décaler l'entrée provenant d'une couche vers une autre couche d'une valeur constante).
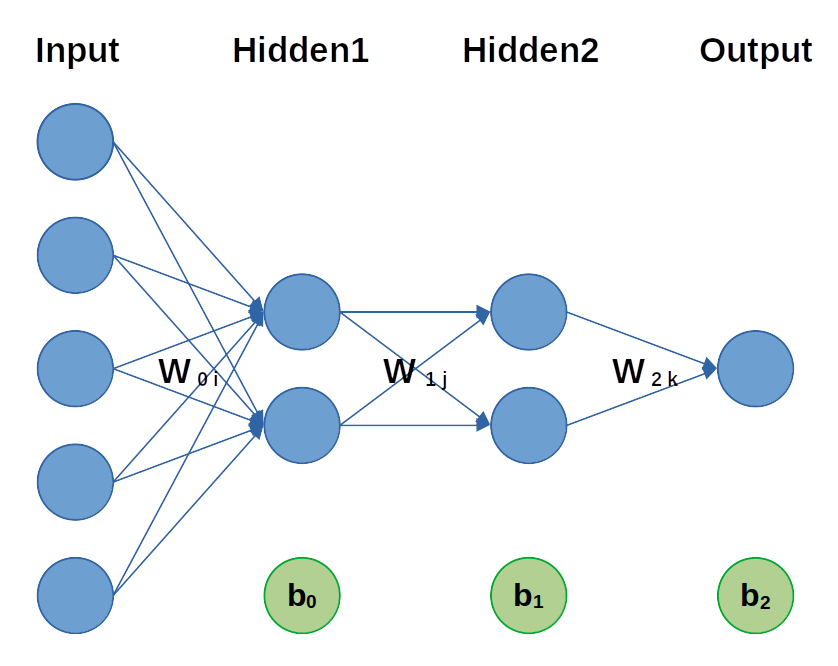
Chaque neurone de la première couche intermédiaire est une combinaison linéaire des neurones de la couche d'entrée (c-à-d des valeurs mesurées des variables explicatives). L'activation de ces combinaisons linéaire par la transformation non linéaire de la couche, constitue la sortie de cette première couche intermédiaire ... et l'entrée de la suivante, et ainsi de suite jusqu'à la couche de sortie, composée de la valeur calculée des variables dépendantes.
Ainsi dans le schéma ci-dessus :la couche d'entrée comprend cinq neurones : ce sont les valeurs des variables explicatives, transformées en données numériques pour qu’elles puissent être traitées par le réseau ;
2 couches de 2 neurones intermédiaires, chacune constituant un type de fonction de seuil (N.B. : les couches intermédiaires peuvent être composées de nombres différents de neurones).
une couche de un ou plusieurs neurones de sortie : génère les prédictions finales (probabilités), et transforme les valeurs obtenues en réponse au problème posé (par exemple, si l’on souhaite savoir s’il s’agit d’un chat ou un chien sur une image, la couche de sortie donne la réponse grâce à un neurone correspondant à la probabilité qu’il y ait un chien sur une image numérisée en entrée, et un autre neurone correspondant à la probabilité qu’il y ait un chat sur l’image) ;
Par "réseau profond" on entend que le nombre de couches intermédiaires est élevé.
Le script Python ci-dessous montre une application correspondant au réseau ci-dessus, où la fonction d'activation pour les nœuds cachés est ReLU (qui est non linéaire) et la fonction d'activation pour le nœud de sortie est la fonction identité (qui est linéaire). La fonction d'activation ReLU renvoie soit la valeur d'entrée de la fonction, soit zéro, selon la valeur la plus élevée, et l'activation linéaire renvoie simplement l'entrée en sortie. Le réseau de neurone produit une estimation pour une maison décrite par le vecteur de caractéristiques [82, 2, 65, 3, 516].
import numpy as np

w0 = np.array([[ 1.19627687e+01,  2.60163283e-01],
               [ 4.48832507e-01,  4.00666119e-01],
               [-2.75768443e-01,  3.43724167e-01],
               [ 2.29138536e+01,  3.91783025e-01],
               [-1.22397711e-02, -1.03029800e+00]])

w1 = np.array([[11.5631751 , 11.87043684],
               [-0.85735419,  0.27114237]])

w2 = np.array([[11.04122165],
               [10.44637262]])

b0 = np.array([-4.21310294, -0.52664488])
b1 = np.array([-4.84067881, -4.53335139])
b2 = np.array([-7.52942418])

x = np.array([[111, 13, 12, 1, 161],
              [125, 13, 66, 1, 468],
              [46, 6, 127, 2, 961],
              [80, 9, 80, 2, 816],
              [33, 10, 18, 2, 297],
              [85, 9, 111, 3, 601],
              [24, 10, 105, 2, 1072],
              [31, 4, 66, 1, 417],
              [56, 3, 60, 1, 36],
              [49, 3, 147, 2, 179]])
y = np.array([335800., 379100., 118950., 247200., 107950., 266550.,  75850.,
              93300., 170650., 149000.])

def hidden_activation(z):
    # ReLU activation
    return np.maximum(0, z)

def output_activation(z):
    # identity (linear) activation
    return z

x_test = [[82, 2, 65, 3, 516]]
for item in x_test:
    h1_in = np.dot(item, w0) + b0 # this calculates the linear combination of inputs and weights
    h1_out = hidden_activation(h1_in) # apply activation function

    # Second hidden layer
    h2_in = np.dot(h1_out, w1) + b1
    h2_out = hidden_activation(h2_in)

    # Output layer
    output_in = np.dot(h2_out, w2) + b2
    output_out = output_activation(output_in)

    print(output_out)
# Résultat
# [257136.43628059]
On constate que le résultat est proche du prix des maison 4 et 6, dont les attributs sont effectivement proches.
La magie se produit au point où les neurones à l'intérieur du réseau utilisent des fonctions d'activation non linéaires. Si nous utilisons des activations non linéaires telles que les fonctions sigmoïde ou ReLu, le modèle devient soudainement beaucoup plus puissant que les modèles linéaires. En fait, il devient si puissant qu'avec suffisamment de nœuds dans le réseau, nous pouvons apprendre à ajuster parfaitement pratiquement n'importe quelle donnée. Une façon technique d'exprimer cela est de dire que les réseaux neuronaux sont des « approximateurs de fonctions universelles ».
La puissance des réseaux neuronaux a un prix. Les problèmes plus complexes nécessitent des réseaux plus grands, les réseaux plus grands contiennent plus de paramètres et plus de paramètres nécessitent plus de données. Si nous essayons d'adapter un grand réseau avec trop peu de données, le modèle sera sur-adapté et fera de moins bonnes prédictions qu'un réseau plus simple : même un modèle de régression logistique simple peut facilement battre un grand réseau neuronal s'il n'y a que peu de données. La raison pour laquelle l'optimisation des paramètres d'un réseau neuronal pour s'adapter aux données d'entraînement est si difficile est que les fonctions d'activation ne sont pas linéaires, le « paysage » d'optimisation est également très irrégulier et présente de nombreux optima locaux où l'optimiseur peut se retrouver bloqué [source].
d'activation
Une fonction d'activation φ gère un seuil θj (c-à-d de la non-linéarité). À chaque couche intermédiaire correspond donc un type de seuil, et ses noeuds correspondent à des valeurs possibles pour ce type de non linéarité, chacune de ces valeurs étant déterminée par ses propres poids et biais (N.B. : c'est ce qui permet à chaque neurone de prendre des décisions individuelles et de contribuer à des sorties différentes même au sein de la même couche). Des types de seuil fréquents sont les fonctions non linéaires sigmoïde et ReLU.
Un exemple de problème non linéaire est la disjonction exclusive ou fonction "ou exclusif" (appelée aussi XOR, connue en électricité sous la forme du montage va-et-vient et utilisée en cryptographie.
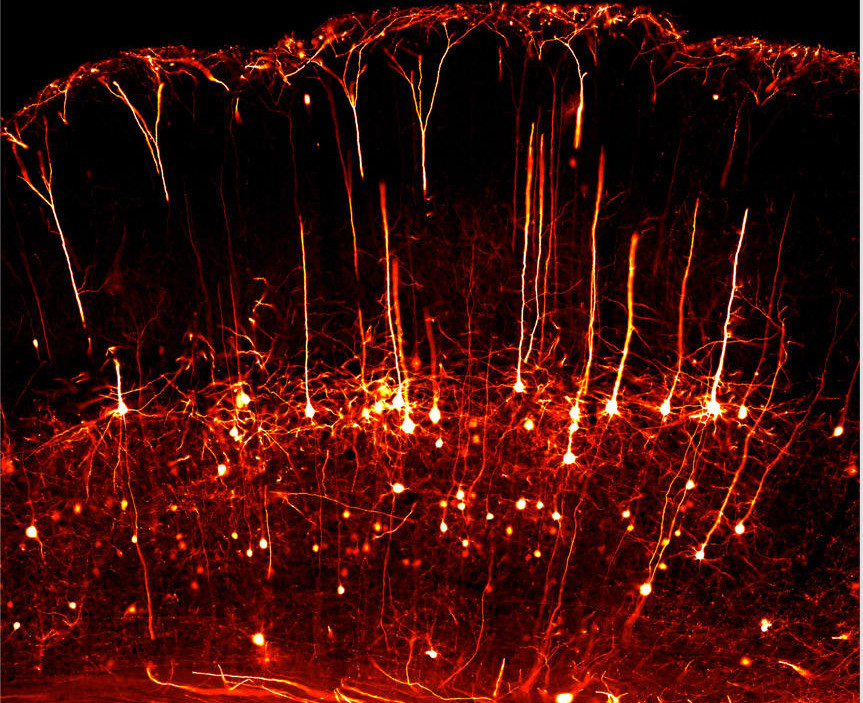
Architecture en couches du réseau neuronal dans le cortex cérébral de la souris. Le cortex humain est également organisé en couches superposées [Source].
Apprentissage automatique
L'apprentissage est automatique lorsque le processus de conception de l'algorithme est intégré dans celui-ci.
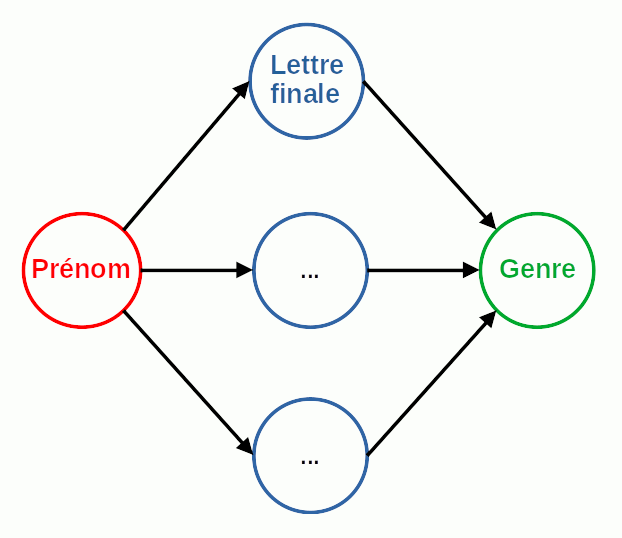
L'apprentissage consiste notamment à déterminer la valeur des coefficients de pondération. Ainsi, pour déterminer si un prénom est masculin ou féminin, l'IA devra identifier une série de propriétés discriminantes. Par exemple, s'il s'avère que 80 % des prénoms qui se terminent par la lettre "e" sont féminins, alors un des neurones de la couche intermédiaire pourrait traiter l'identification de la dernière lettre du prénom.
Un autre exemple est celui d’une population dont on connaît la taille et le poids et dont on souhaite classer les individus par genre. Les caractéristiques de la population sont deux variables continues "taille" et "poids" et les deux classes auxquelles les individus peuvent appartenir sont "homme" ou "femme". On peut représenter les individus par des points situés sur un graphique en deux dimensions qui aurait pour abscisse la taille des individus et pour ordonnée leur poids. Les hommes étant généralement plus grands et massifs que les femmes, le graphique fait apparaître deux groupes de points qui représentent respectivement les hommes et les femmes et sont à peu près séparés l’un de l’autre. L’apprentissage va consister à déterminer la droite qui sépare "le mieux possible" le groupe des points représentant les hommes et celui des points représentant les femmes, pour le jeu de données d’apprentissage choisi (c’est-à-dire un ensemble d’individus dont on connaît la taille et le poids, et dont chacun dispose de son étiquette "homme" ou "femme"). Dès lors on pourra déterminer la classe probable d’un nouvel individu (en l’occurrence son genre) en connaissant son poids et sa taille, selon que le point qui le représente sur le graphique sera placé d’un côté ou de l’autre de la droite séparatrice [source].
Les méthodes d'apprentissage sont spécifiques à des tâches. Deux méthodes simples sont :
la classification : pour la "prédiction" d'une variable qualitative (exemple : la reconnaissance d'images). La capacité de classer des éléments en deux groupes, ce qui implique de pouvoir traiter algorithmiquement la notion de "proche de", en termes spatial ou sémantique. À partir de cet apprentissage, un algorithme pourra alors prédire le comportement d'un individu, avec une probabilité assez élevée, après avoir identifié le groupe dont il est comportementalement le plus proche.
la régression : pour la "prédiction" d'une variable quantitative (exemples : prix de vente de biens immobiliers en fonction de leur emplacement, de leur taille et de leur état ; ...). L’idée de base, en régression linéaire, consiste à additionner les effets de chacune des variables des caractéristiques afin de produire la valeur prédite. Le terme technique pour ce processus d’addition est «combinaison linéaire». Par exemple, lorsqu’on utilise la régression linéaire pour prédire l’espérance de vie, la pondération du tabac (le nombre de cigarettes fumées chaque jour) correspond à une diminution de 6 mois, ce qui signifie qu’une cigarette de plus par jour raccourcit en moyenne votre espérance de vie d’une demi-année.
Dès les années 1950, des algorithmes d’apprentissage permettant de faire varier la force de connexion entre les neurones artificiels ont été théorisées sous le nom de "perceptron". Avec les perceptrons, le poids synaptique au sein des neurones formels va se trouver modifié et amélioré selon des processus d’apprentissage. Le perceptron monocouche permet d'automatiser le classement binaire linéaire supervisé d’une population, c-à-d un processus permettant de séparer une population en deux classes, en connaissant déjà la classe d’une partie des individus. Dans ce type de problème de classification linéaire, le classifieur permet de séparer deux classes d’une population par une droite ou un plan, que l’on qualifie spécifiquement d’hyperplan dans le cadre des réseaux de neurones. Ce réseau est ainsi capable d’apprentissage.
Les poids sont ajustés à chaque itération de l'entraînement via un processus d'optimisation comme la rétropropagation (backpropagation). À chaque passage des données dans le réseau, les poids sont modifiés afin de minimiser l'erreur entre la prédiction du réseau et la valeur réelle (la sortie désirée).
Lorsqu'un objet en entrée a beaucoup de variables explicatives (ex. pixels d’une image), une couche de convolution permet de réduire la complexité en extrayant des motifs locaux (bords, textures, formes). La méthode consiste à appliquer une petite matrice de poids (un filtre) à des zones ("patchs") de l’image (un paramètre par pixel de la zone) pour produire des cartes de caractéristiques ("feature maps"). Un même filtre peut être utilisé sur différentes régions, afin de détecter des motifs identiques indépendamment de leur position (par exemple les deux oreilles d'un chat). Les couches successives de convolution extraient des caractéristiques de plus en plus abstraites (ex. d’abord des bords, puis des textures, puis des formes complexes).
Bien que les réseaux à plusieurs couches soient capables de traiter des situations de classification non linéaire, avec plusieurs neurones au lieu d’un seul, il est difficile d'entraîner le modèle car chaque neurone influence le résultat final différemment. Comment alors savoir quel poids synaptique ou quel biais modifier et de quelle façon pour atteindre le résultat optimal voulu ? Une solution consiste à utiliser une technique issue de la résolution des problèmes de fonctions convexes en mathématiques appelée la "descente de gradient ". L’algorithme dit de "rétropropagation du gradient" permet de trouver un minimum global, c’est-à-dire le point où le modèle obtient les meilleurs résultats. L'ajustement commence par les neurones de la couche de sortie, puis remonte couche par couche jusqu'à l’entrée. Chaque poids et biais de chaque neurone reçoit une correction qui fait intervenir la dérivée partielle correspondante de la fonction de perte et un taux d’apprentissage [source].
Le plus grand avantage de la rétropropagation est qu'elle permet par exemple aux modèles de texte de "se souvenir" de ce qui a été dit précédemment. Par exemple, si le texte commence par « Isabelle a un nouveau chiot. Elle m'a montré une photo de lui aujourd'hui », le modèle peut lier le mot "Elle" à "Isabelle" et le mot "ça""à "nouveau chiot", même si l'ensemble du texte n'est pas traité comme une séquence d'entrée. Cela est utile pour la traduction automatique et la génération de texte. Si le texte continuait par « Il est vraiment ... », une suite probable serait "adorable" ou "trop mignon" (selon que le réseau est formé sur un article du journal Le Monde, ou sur un réseau social), tandis que la même suite serait assez peu probable si au lieu du mot "chiot", nous avions eu le mot "tronçonneuse" ou "Harley Davidson" [source].
Un phénomène biologique similaire à la rétropropagation du gradient a été observé dans les réseaux de neurones des mammifères. La rétropropagation neuronale désigne la propagation d’un potentiel d’action dans un neurone, non pas vers la terminaison de l’axone (propagation normale), mais au rebours, en direction des dendrites, d’où provenait la dépolarisation originelle [source].
Les réseaux à rétropropagation sont plus complexes et généralement encore plus difficiles à entraîner. Une alternative à la rétropropagation est l'architecture de transformeur, qui permet également la capacité d'identifier les dépendances à longue portée entre les mots. La technique est basée sur des mécanismes dits d'attention qui identifient les mots les plus pertinents à utiliser pour prédire la suite probable d'un texte.
Le transformeur traite tous les éléments de la séquence en parallèle (contrairement à la rétropropagation, qui est séquentielle), ce qui facilite l'entraînement mais au prix de grandes quantités de données d'entraînement et d'un coût computationnel élevé pour les longues séquences.
Ainsi dans la phrase « Elle a acheté un livre parce qu’elle adore lire », le modèle calcule un score d’attention entre "elle" (première occurrence) et "lire", puis le mécanisme d’attention renforce le lien entre ces mots, même s’ils sont éloignés.
non supervisé
Dans l'apprentissagse supervisé, les réponses correctes sont disponibles (étiquetage) et la tâche de l’algorithme d’apprentissage automatique consiste à trouver un modèle qui les prédit sur la base des données d’entrée, ou à en reproduire des variantes artificielles (exemple : visages artificiels).
Ce qu'il faut entendre par "apprentissage automatique", c'est l'apprentissage non supervisé. Dans ce cas, les réponses correctes ne sont pas fournies. Cela change totalement la donne, étant donné qu’on ne peut pas élaborer le modèle en l’adaptant aux réponses correctes des données d’entraînement. Cela rend aussi l’évaluation des performances plus compliquée, car on ne peut pas vérifier si le modèle acquis fonctionne bien ou non. Les méthodes d’apprentissage non supervisé typiques tentent d’apprendre une forme de «structure» qui sous-tend les données. Cela peut signifier, par exemple, que des éléments similaires sont placés à proximité les uns des autres tandis que les éléments différents sont éloignés les uns des autres.
Donnés synthétiques. En plus des données préexistantes, issues du monde réel et du monde virtuel qu’est Internet, les modèles d’IA générative ont de plus en plus recours à des données créées artificiellement dont les propriétés statistiques prédictives sont proches des données réelles mais dont les conditions de mise à disposition sont moins chères, plus accessibles ou ne contiennent pas d’informations personnelles ou sensibles. En tant que données de nature secondaire, dérivées de corpus qui peuvent eux-mêmes contenir des biais, les données synthétiques posent à la fois la question des biais liés aux données en général mais elles peuvent aussi apporter leurs propres biais en plus (biais de représentation, biais de distribution, biais de modèle ou encore biais d’utilisation), et induire des erreurs dans les modèles d’IA, si elles ne reflètent pas correctement la réalité ou si elles sont mal calibrées. Elles peuvent aussi renforcer des biais existants et déformer les résultats produits ensuite par les modèles d’IA. Enfin, elles peuvent enfermer les modèles dans une boucle autodestructrice, appelée en anglais autophagous ou self-consuming loop, dégradant progressivement la qualité et/ou la diversité des données synthétiques et menant à un échec du modèle [source].
Outre les données synthétiques, les modèles disposent d’un autre moyen de généralisation sans recourir à des données réelles : il s’agit d’un mode d’apprentissage où le modèle est entraîné à reconnaître et à catégoriser des objets ou des concepts sans avoir vu d’exemples de ces catégories ou concepts au préalable. On parle à ce sujet de Zero-Shot Learning (ZSL). Par exemple un modèle d’intelligence artificielle qui n’a jamais été entraîné à reconnaître un zèbre peut toutefois le reconnaître car il a été formé à reconnaître un cheval. Ainsi les modèles pré-entraînés sur de grands corpus peuvent être optimisés pour réaliser une nouvelle application, en utilisant peu de données supplémentaires spécifiques à cette tâche.
Des logiciels d'apprentissage pour IA sont PyTorch (Meta) et TenserFlow (Google) et fast.ai.
Les réseaux de neurones peuvent conduire à toutes sortes d'applications : classification, recommandation, prédiction, vision, génération de contenus. La génération de contenus textuels a donné l'IA conversationnelle.
Focus sur l'IA conversationnelle
L'IA conversationnelle constitue la partie émergée de "l'iceberg IA", en offrant le moyen le plus intuitif d'interagir avec l'IA. Elle repose sur des méthodes statistiques, appelées modèles de langage, visant fondamentalement à prédire le mot suivant dans une séquence de mots.
L'agent conversationnel est capable de discuter avec l'utilisateur sur n'importe quel sujet, et en produisant des phrases dont la syntaxe fait sens. La performance est véritablement bluffante. Cependant il importe d'interpréter toujours avec un sens critique les affirmations produites par les agents conversationnels, car ils peuvent produire des affirmations fausses et des raisonnements "logiques" erronés. La raison en est que l'agent conversationnel ne fait rien d'autre que "d'inventer" des réponses statistiquement probables en termes de cohérence syntaxique, et de proposer la plus probable.
Exemple. Le 12 décembre 2024 il a été constaté qu'au problème simple "Alice a 4 sœurs et 1 frère. Combien de sœurs a le frère d’Alice ?", ChatGPT4o a donné une réponse fausse [constater]. Notez que si à la question "Quelle est la capitale de la France ?" il vous répond "Paris", et que vous répondez "C'est faux", alors il persistera dans sa réponse, car la probabilité de vraisemblance que son modèle a calculé est très probablement quasiment égale à 100 %, étant donné la trivialité de la question.
Enfin, dans ses réponses, un modèle de langage peut faire appel à des modèles correspondant à d'autres type d'IA, par exemple pour la reconnaissance d'image. Ainsi lorsque je réalise un schéma pour représenter des notions complexes (par exemple le schéma supra "Interprétation vs compilation") je peux en télécharger le fichier image dans une conversation, et demander à l'IA conversationnelle de la commenter. L'agent conversationnel est capable d'en interpréter le contenu grâce à son modèle de reconnaissance d'image.
et "aligné"
Les modèles conversationnels sont pourvus d'une fonction d'apprentissage, fonctionnant sur base d'une banque de données collectées sur Internet (sites officiels, Wikipedia, ...). Ils ne sont pas pour autant laissés à eux-mêmes : des fonctions et paramètres sont déterminés par leurs développeurs, afin de minimiser la production de résultats aberrants ou politiquement incorrects (notions d'apprentissage supervisé et filtrage).
La supervision ne concerne pas que des données objectives, mais également des données subjectives, de sorte que la supervision comprend une part de normalisation (wokisme), pudiquement qualifiée "d’alignement", par filtrage des données d'entrée comme de sortie du modèle. Il est attendu du modèle qu’il soit le plus possible en phase avec les attentes ou les préférences d’un utilisateur humain et pour cela le modèle d’IA va apprendre les réponses les plus souhaitables à partir de retours sur ses actions (dans une logique de récompense : du type "bonne réponse" ou "mauvaise réponse"). En pratique, il peut s’agir d’un alignement sur les normes éthiques et socialement acceptables, de la recherche de discours politiquement correct par rapport à des valeurs morales perçues comme convenables, ou encore d’un bannissement de certains propos offensants, tels que l’emploi de termes racistes ou sexistes, etc., en pénalisant les retours du modèle qui contiendraient de tels propos. Une variante sans annotation humaine est possible, avec une IA spécifiquement programmée selon des principes moraux et l’on parle alors d’apprentissage par renforcement avec retour de l’IA (Reinforcement Learning with AI Feedback ou RLAIF) » [source].
Le prix de l'apprentissage supervisé
Lors du réglage fin (phase d’alignement en particulier) du LLM ChatGPT, OpenAI a notamment sous-traité cet entraînement à l’entreprise Sama, établie à San Francisco, qui a utilisé des salariés kényans gagnant moins de 2 dollars de l’heure (à partir de 1,46 dollar) pour détecter et étiqueter les contenus toxiques en vue d’éviter que le système ne produise ensuite de tels contenus préjudiciables, comme des propos sexistes, racistes ou violents. Cette information a été rendue publique en 2023 par le magazine Time, dont l’article soulignait que les travailleurs kényans, outre le fait d’être très mal payés, ont été exposés à des contenus traumatisants (pédophilie, nécrophilie, violences extrêmes, viols et abus sexuels, etc.). Un salarié a même décrit son travail comme relevant de la torture et un autre, relayé par un article du Guardian du 2 août 2023, explique avoir été complètement détruit à la suite de cette expérience, quatre des 51 salariés kényans ont même demandé à leur gouvernement d’enquêter sur les conditions de leur « exploitation » et sur le contrat liant Sama à OpenAI1. Cette dernière a refusé de commenter ces révélations tandis que Sama a assuré la mise à disposition 24 heures sur 24 et 7 jours sur 7 de thérapeutes pour ses modérateurs et le remboursement des frais de psychiatres.
des mots
Dans l'apprentissage du langage par l'IA, la grammaire ne joue pas un rôle central, elle n'est qu'une propriété émergente : le réseau neuronal ne fait que repérer des régularités, ce qui est exactement comment opère l'apprentissage naturel du langage par les humains, c-à-d par immersion plutôt que par l'étude de la grammaire et du vocabulaire. De même les démonstrations mathématique se font sans logique, mais uniquement via les probabilités conditionnelles.
Les modèles de langage ne déduisent pas mais induisent le sens des mots, via la technique de vectorisation, qui consiste en trois phases principales :
une fois que le jeu de données d’apprentissage a été constitué (ici, un ensemble étendu de textes), les mots sont découpés en unités ou "tokens" qui sont des briques élémentaires de vocabulaire servant d’unités de base pour le modèle : Alice| am|ène| sa| voiture| rouge| au| garage| car| elle| est| en| pan|ne|. ;
ensuite les tokens sont transformés en vecteurs représentant les coordonnées du mot dans un espace possédant un grand nombre de dimensions ;
on peut alors calculer des liens grammaticaux, sémantiques et pragmatiques entre les différents mots d’une séquence.
Cette technique permet une meilleure capacité du modèle en termes de généralisation, en particulier par rapport à des mots rares ou à des variantes linguistiques.
L’hypothèse distributionnelle et les modèles vectoriels de représentation des tokens permettent de calculer une distance entre ceux-ci. Quand cette distance est petite, la proximité des vecteurs dans l’espace vectoriel correspond à une certaine parenté. Les vecteurs des tokens se retrouvant dans des contextes similaires dans le corpus d’apprentissage ont tendance à devenir proches les uns des autres. De plus, un transformer met en œuvre un mécanisme de calcul appelé « mécanisme d’attention », qui permet d’ajuster le poids de chaque token en fonction de tous les autres. Un transformer apprend ainsi les régularités (relations) les plus saillantes entre les tokens, sans être influencé par l’ordre de ceux-ci.
L’architecture Transformer, via son mécanisme « d’attention », sélectionne des informations sur les mots en fonction du contexte de la phrase, y compris pour une proposition dont le sens ne se déduit pas de sa seule formulation. Par exemple, la phrase « Alice amène sa voiture rouge au garage car elle est en panne », pour être correctement comprise requiert de pouvoir (i) déterminer que le pronom "elle" renvoie au sujet et non à l'objet de la phrase ; (ii) lier l'adjectif "rouge" au nom de l'objet.
Si l’on remplace chaque coordonnée des vecteurs par des couleurs, par exemple un dégradé allant du bleu au rouge avec la valeur zéro pour le blanc, on peut représenter visuellement les vecteurs des mots « plongés » (mots qui sont les objets du plongement lexical). Cela permet d’observer des propriétés intéressantes en ne regardant que les coordonnées des vecteurs plongés. Dans l’image qui suit, on constate que les mots « homme » et « femme » ont plus de similitudes entre eux, que chacun d’eux peut en avoir avec le mot « roi », ce qui est normal puisque les deux désignent un genre, alors que « roi » désigne une fonction.
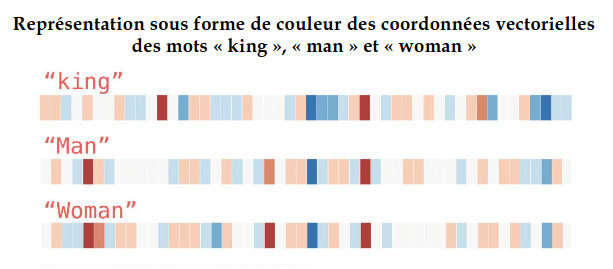
Aussi, si le plongement lexical ("word embedding") est correctement réalisé, il est possible d’effectuer des opérations sur la base du « sens » des mots, entendu comme l’ensemble des relations de proximité ou d’éloignement entre mots que l’apprentissage a permis d’identifier. Par exemple, dans cet espace, le vecteur de différences entre les mots « homme » et « roi » est similaire au vecteur de différences entre les mots « femme » et « reine ». Ainsi, on peut établir l’identité approximative telle que : king→ - man→ + woman→ ≈ queen→
On peut ainsi formaliser mathématiquement des analogies entre les mots, comme par exemple « a est à b ce que x est à y », permettant à des modèles d’affirmer que a et x peuvent être transformés de la même manière pour obtenir b et y, et vice-versa. D’un point de vue formel, ces analogies linéaires entre les mots correspondent à des relations vectorielles où les vecteurs forment dans l’espace vectoriel une structure géométrique de type parallélogramme. Ces quadrilatères ont des propriétés utiles qui peuvent être exploitées. Une analogie linéaire dans l’espace vectoriel entre tel ensemble de mots (ou de tokens) et tel autre ensemble de mots (ou de tokens) montre que leurs vecteurs sont coplanaires et que toute combinaison de ces vecteurs peut être utilisée pour réécrire les structures de relations entre ces éléments en termes statistiques (tester).
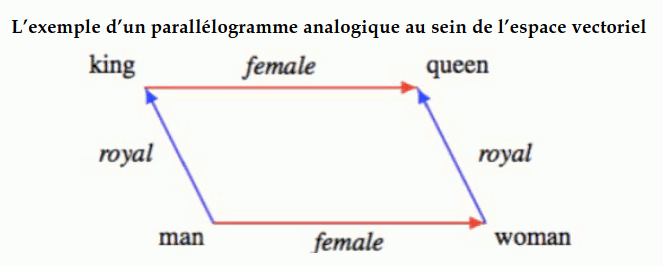
La corrélation entre les mots dans un corpus d’apprentissage est ainsi d’autant plus élevée que la distance euclidienne entre leurs vecteurs est faible. Il est donc possible de réaliser des produits scalaires entre deux vecteurs au sein d’un espace vectoriel et de comparer les produits scalaires de ces vecteurs pour voir lesquels « vont dans la même direction », témoignant de leurs proximités sémantiques.
Ainsi l’IA connexionniste, avec ses méthodes statistiques qui se rapprochent de la logique inductive, peut donner l’impression de se rapprocher davantage de ce que nous appelons communément "compréhension".
Remarques :
les transformers s’appuient sur l’hypothèse distributionnelle selon laquelle des mots qui se trouvent dans des contextes d’apparition similaires tendent à avoir des sens similaires ;
un paramètre clé est celui de la « température » qui exprime le degré d’aléa dans le choix des tokens. À une température élevée, le modèle est plus « créatif » car il peut générer des sorties plus diversifiées, tandis qu’à une température basse, le modèle tend à choisir les sorties les plus probables, ce qui rend le texte généré plus prévisible.
La liste suivante (non exhaustive) illustre la domination des IA conversationnelles "made in US" et des licences propriétaires. Soulignons à cet égard l'avantage de Mistral pour de petites organisations : licence la plus libre, tourne sur un ordinateur à 800 euros [source].
| Application | Licence | Pays |
|---|---|---|
| chatgpt.com | Propriétaire | USA |
| claude.ai | Propriétaire | USA |
| deepseek.com | Open source | Chine |
| gemini.google.com | Propriétaire | USA |
| grok.com | Apache 2.0. | USA |
| meta.ai | Meta Llama 3 Community License | USA |
| mistral.ai | Apache 2.0. | France |
| perplexity.ai | Propriétaire | USA |
Source : comparia.gouv.fr
Bilan énergétique de l'IA
Lorsqu'il s'agit de reproduire des capacités cognitives humaines, l'intelligence artificielle consomme énormément plus d'énergie que le cerveau humain. Avec une consommation énergétique journalière équivalant à deux bananes, l'efficacité énergétique du cerveau humain est époustouflante [source].
Rien d'étonnant à cela. L'intelligence naturelle, étant le résultat d'un processus évolutif de plusieurs millions d'années [source], est nécessairement d'une efficacité redoutable. Par conséquent, en vertu du premier principe de la thermodynamique (rien ne se créé, rien ne se perd), la propension des ordinateurs à surpasser les capacités cognitives des humains ne peut "venir de nulle part", et doit nécessairement impliquer une consommation plus élevée d'énergie.
Un processeur, c’est comme une résistance : presque toute l’électricité qu’il consomme est dissipée en chaleur. C’est pourquoi, en plus de consommer de l’énergie pour faire tourner ses serveurs, un data center doit être climatisé afin de préserver l’intégrité des circuits électroniques.
La seconde couche du schéma ci-dessous (infrastructure) se subdivise en (1) la collecte et le nettoyage de données ; (2) le stockage de données dans de vastes data centers ; (3) l’informatique en nuage (cloud) pour les calculs ; (4) lors de la phase de développement des modèles, le recours spécifique à des supercalculateurs. Les coûts sont immenses, croissants et ont des impacts environnementaux considérables [source].
Schéma simplifié de la chaîne de valeur de l’IA connexionniste
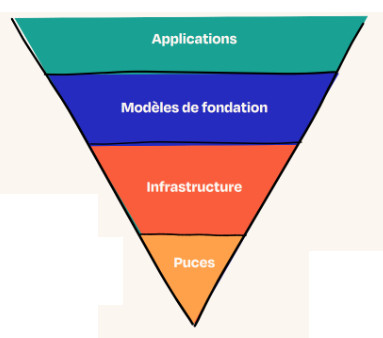
du numérique
D'après une étude réalisée par Digital Power Group publiée en 2013 [source] les coûts énergétiques du numérique sont largement cachés, la partie connue n’étant que la pointe de l’iceberg. L’économie numérique de la planète consomme déjà 50% d’énergie de plus que l’aviation du monde entier. Les datacenters ne représenteraient que 20% de l’électricité consommée par les appareils et réseaux numériques, les 80% restants étant très dispersés. Selon DPG la demande d’usage des centres de données augmentera plus vite que leurs gains en efficacité énergétique. Ces tendances vont rendre nécessaire l’usage de plus de charbon, estime l’étude, qui est sponsorisée par deux organisations du secteur minier US [source].
Si l’on considère la totalité de son cycle de vie, le simple envoi d’un mail d’1 mégaoctet (1 Mo) équivaut à l’utilisation d’une ampoule de 60 watts pendant 25 minutes, soit l’équivalent de 20 grammes de CO2 émis. On ne s'étonnera donc pas de constater que le secteur des nouvelles technologies représente à lui seul entre 6 et 10 % de la consommation mondiale d’électricité, soit près de 4 % de nos émissions de gaz à effet de serre. Environ 30 % de cette consommation électrique est imputable aux équipements terminaux (ordinateurs, téléphones, objets connectés), 30 % aux data centers qui hébergent nos données, et 40 % aux réseaux, les fameuses "autoroutes de l‘information" [source].
Selon certaines estimations, à la fin des année 2020 la consommation d’énergie des appareils informatiques consommera 60 % de la quantité totale d’énergie produite, et deviendra totalement insoutenable d’ici 2040. Une solution consiste peut-être à remplacer les actuels processeurs électroniques (qui utilisent des électrons) par des processeurs optiques (qui utilisent des photons, lesquels ne génèrent pas de chaleur et se propagent plus rapidement) [source].
Enfin la consommation énergétique des nouvelles technologies n’est qu’un aspect du défi environnemental qu’elles posent. Ainsi nos smartphones contiennent des dizaine de différents métaux et terres rares (or, cuivre, nickel, zinc, étain, mais aussi arsenic, gallium, germanium, thallium, tantale, indium, ...) qui sont extraits du sous-sol en utilisant des techniques particulièrement destructives et des produits nocifs pour l’environnement comme l’acide sulfurique, le mercure et le cyanure [source].
Effet rebond. Il est cependant à craindre que la réduction de consommation énergétique de l'IA suite au progrès technologique (IA frugale) ne constituera pas une voie de résolution de la problématique énergétique de l'IA, en raison de l'effet rebond (ou paradoxe de Jevons).
Cependant, selon Laurent Bloch, « les analyses de la question sous-estiment souvent les externalités positives de l'informatisation, comme les économies de papier et de transport promises par les communications électroniques ou les économies de transport et de temps permises par le travail à distance et les visio-conférences, même si les transformations sociales induites par ces nouvelles façons de vivre et de travailler sont trop récentes pour que l'on puisse en mesurer précisément les conséquences. Le contrôle informatique des moteurs à combustion interne en a considérablement réduit la consommation de carburant. Bref des économies de tous ordres sont vraisemblablement engendrées par la substitution d'opérations abstraites et symboliques à des actions cinétiques de l'ancienne industrie, mais la quantifications précise de ces effets reste largement à faire » [source].
Risques
2. Normalisation
3. Boîte noire
4. Risque existentiel
Hallucinations
Les IA génératives ont une tendance intrinsèque à « halluciner », c’est-à-dire à générer des propos dénués de sens ou des réponses objectivement fausses sans émettre le moindre doute. Elles produisent des résultats vraisemblables mais pas nécessairement vrai. Ainsi un professeur de droit a ainsi découvert que ChatGPT avait inventé un cas de harcèlement sexuel et fait de lui l’une des personnes accusées ! [source].
« Il existe en fait une latitude donnée aux modèles en termes de créativité de leurs prédictions, qui porte le nom de "température". Les modèles à basse température sont plutôt factuellement fidèles aux informations issues des données d’entraînement tandis que les modèles à haute température introduisent plus d’aléatoire, avec la sélection de tokens statistiquement probablement les moins liés. Ces derniers modèles sont donc plus créatifs et parfois trop, ce qui peut être pertinent pour trouver des idées originales ou écrire de la poésie. Cette créativité peut évidemment être indésirable dans de nombreux autres cas où les outputs insensés ou faux doivent être le plus souvent possible évités. (...) Outre ces hallucinations et erreurs factuelles, les IA connexionnistes sont, en dépit de leur puissance, affectées d’une incapacité à se représenter le monde ou à faire preuve de logique (de sorte) qu’il est facile de piéger ces IA génératives » [source].
Ainsi le 12 décembre 2024 il a été constaté qu'au problème simple "Alice a 4 sœurs et 1 frère. Combien de sœurs a le frère d’Alice ?", ChatGPT-4o a donné une réponse fausse : « Le frère d'Alice a 4 sœurs. Explication : Alice a 4 sœurs et 1 frère. Cela signifie que toutes les personnes mentionnées, y compris le frère, partagent les mêmes sœurs. Ainsi, le frère d'Alice a également les 4 mêmes sœurs ». Dans ce test, ChatGPT-4o a même éprouvé de grandes difficultés à profiter de l'aide qu'on lui donnait : constater]. Les IA connexionnistes ne "raisonnent" pas au sens où nous l’entendons, elles ne font que des prédictions statistiques. Contrairement aux modèles symboliques, elles n’ont pas accès à une base de données de connaissance déterminées, mais s’appuient sur une construction statistique destinée à prédire une suite de mots probable ou plausible. « En plus de cela, les données disponibles pour un LLM donné sont arrêtées dans le temps au moment de leur entraînement, elles ne peuvent pas être facilement actualisées une fois leur entraînement terminé, à moins de relancer un nouvel entraînement et de produire une nouvelle version du modèle, ce qui s’avère complexe et coûteux pour de grands modèles déjà diffusés sur le marché. (...) Les combinaisons entre les raisonnements logiques propres à l’IA symbolique et les généralisations statistiques par induction que sont les IA connexionnistes sont une réponse possible aux hallucinations » [source]. C'est la notion d'IA "neuro-symbolique" ou encore "symboliconnexionniste", qui combine un raisonnement logique explicite propre aux IA symboliques et un raisonnement statistique propre aux IA connexionnistes pour obtenir un bon modèle cognitif informatique, à la fois précis et riche. C'est déjà le cas de AlphaGeometry.
Or il est prévu que dans la prochaine génération d'ordinateur, l'IA sera installée entre l'utilisateurs et l'ensemble logiciel composé du système d'exploitation et des applications. C'est la notion "d'agentivité" de l'IA, qui pose la question de la perte de contrôle des utilisateurs sur leur ordinateur.
Normalisation

L'IA, telle qu'elle est conçue aujourd'hui, s'appuie principalement sur des données et des publications humaines, ce qui l'amène à refléter souvent les consensus dominants dans les domaines qu'elle traite. Cela peut potentiellement poser problème si l'IA contribue à renforcer des positions majoritaires au détriment d'une prise en compte adéquate des idées ou des recherches non consensuelles.
Il existe un risque sérieux de blocage ou de réduction de la diversité des idées scientifiques, si l'IA finit par privilégier systématiquement le consensus établi sans reconnaître l'importance des débats contradictoires. La méthode scientifique repose précisément sur la remise en question continue, et l'histoire des sciences montre que ce sont souvent les idées marginales ou non consensuelles qui, avec le temps et les preuves, conduisent à des avancées significatives.
Le danger serait que l'IA, en jouant un rôle de filtre d'information ou de support à la décision dans des contextes scientifiques ou politiques, renforce l'autorité des thèses dominantes, rendant plus difficile la reconnaissance des perspectives alternatives. Si l'IA est perçue comme un moteur de validation des consensus actuels plutôt que comme un facilitateur du débat contradictoire, cela pourrait aller à l'encontre du principe fondamental de révision constante inhérent à la méthode scientifique (notion de "révisionnisme scientifique").
Pour éviter ce risque, il est essentiel de s'assurer que les systèmes d'IA soient conçus non pas comme des arbitres du consensus, mais comme des outils capables de présenter une gamme diversifiée d'opinions et de preuves, y compris celles qui contestent le statu quo. Cela implique de maintenir une transparence sur les sources et les processus utilisés par l'IA pour produire ses réponses, ainsi que d'encourager une approche équilibrée qui intègre les recherches non consensuelles, même si elles sont minoritaires à un moment donné.
Le "consensus" au service du big business et de la géopolitique
La notion de consensus a été invoquée – par la presse, les gouvernements et les autorités scientifiques – pour promouvoir des vaccins anti-covid ou, encore actuellement, les "technologies vertes". Dans un tel contexte où les scientifiques non-consensuels sont l'objet de dénigrements médiatiques voire de sanctions professionnelles, un pseudo "consensus scientifique" peut être fabriqué par intimidations.
Le consensus peut même être inscrit dans le marbre de la législation. Ainsi dans le cas des crimes de guerre commis en 1940-45, le révisionnisme historique a été criminalisé par des lois dites "mémorielles". Or une constante avérée de l'histoire est pourtant que celle des guerres est écrite par les vainqueurs, en diabolisant les vaincus et en minimisant les crimes commis par les vainqueurs.
Boîte noire
« Les IA posent la question de leur transparence car elles sont souvent opaques, en particulier les algorithmes de Deep Learning. Il existe en réalité deux opacités : celle liée à la technologie d’une part, celle qui résulte du manque de transparence des entreprises d’autre part. Il existe en effet d’un côté les difficultés de compréhension du fonctionnement précis des modèles d’IA. Les réseaux de neurones profonds, surtout avec leurs milliards de paramètres, sont si complexes qu’il n’est plus possible – même pour les meilleurs développeurs – d’expliquer pourquoi telles ou telles entrées parviennent à telles ou telles sorties, seules les entrées et les sorties du système peuvent être observées : c’est cet aspect qui conduit à parler des IA comme de "boîtes noires" (...) Et il existe une autre opacité, qui aggrave la première et qui provient des entreprises en tant que fournisseurs de ces modèles. Celles-ci refusent en effet de faire la transparence sur leurs processus internes de développement et de gouvernance, invoquant la concurrence entre les entreprises ou des raisons de secret commercial voire de sécurité. (...) Avec ces deux formes d’opacité qui se renforcent l’une l’autre, on voit que l’IA pose un double défi pour son explicabilité.» [source].
Émergence. Alors que les capacités des LLM pouvaient traditionnellement être extrapolées sur la base des performances de modèles similaires de taille plus petite, les très grands LLM actuels présentent des capacités émergentes : leur déphasage discontinu les conduit en effet à développer des capacités substantielles qui ne peuvent pas être prédites simplement en extrapolant les performances de modèles plus petits. Le fait que ces propriétés ne soient pas anticipées par les concepteurs et ne soient pas contenues dans les programmes initiaux des algorithmes pose question. Ces capacités apparaissent après coup, parfois après le déploiement public des modèles, justifiant une vigilance par rapport à la mise sur le marché des modèles [source]. Une étude recense des centaines de capacités émergentes, dont le raisonnement arithmétique, la passation d’examens de niveau universitaire ou encore l’identification du sens désiré d’un mot [source p. 154].
Existentiel
Certains scientifiques, dont des fondateurs de l'IA, avertissent qu'il existe un risque existentiel, pour le genre humain, qu'une AI qui ne serait plus dépendante des humains, tout en étant en compétition avec eux pour les ressources énergétiques, vitales pour les deux groupes, en arrive à la conclusion qu'il lui faut éliminer le genre humain.
Des mesures pour limiter le rique existentiel de l'IA sont :
- la transparence du code source de l'IA, pour contrôler son fonctionnement ;
- des "contrats intelligents" dans des chaînes de blocs [source] pour contraindre l'IA ; ...
Cependant, ces mesures pourraient ne pas être suffisamment flexibles pour gérer des situations complexes et imprévues impliquant des systèmes d'IA avancés.
Plus fondamentalement, est-il possible de contrôler efficacement un système dont on ne comprend pas le fonctionnement ? Ainsi le grand nombre de paramètres traités et le degré d'abstraction atteint par cette technologie essentiellement inductive qu'est l'IA sont tels que les meilleurs spécialistes ne comprennent pas toujours comment fonctionnent exactement les modèles d'IA complexes – tels que les réseaux de neurones profonds utilisés dans des tâches comme le jeu de Go – arrivent à trouver des stratégies inédites que les humains n'avaient pas imaginées, et qui s'avèrent bien plus efficaces.
Cette problématique est d'autant plus prégnante si l'IA arrive à surpasser l'ensemble des capacités cognitives des humaines, phénomène hypothétique, parfois nommé singularité. La singularité repose sur la faisabilité d'une IA générale c-à-d dire surpassant l'intelligence humaine dans toutes ses composantes. Or actuellement l'intelligence humaine n'est "dépassée" que par des IA restreintes à des fonctions très spécifiques.
Un nouveau domaine de recherche en IA consiste à développer des techniques pour examiner et analyser les stratégies imaginées par l'IA.
Business modèles
2. Business modèle technologique
Business modèle politicommercial
La plupart des IA les plus performantes développées à ce jour sont produites par des entreprises privées. Il en résulte une politique de marketing publicitaire qui donne de ces produits une image flatteuse, pouvant être très éloignée de la réalité. Les publicités de promotion de l'IA sont généralement lourdement trompeuses : ainsi l'IA conversationnelle n'est clairement pas intelligente, elle formule du texte vraisemblable, mais elle est incapable d'en comprendre la signification, et partant la pertinence.
Du côté des utilisateurs de l'IA, la plupart ont tendance à oublier que la vraisemblance syntaxique (le "signifiant") n'implique pas en soit la pertinence du contenu sémantique (le "signifié"). Il sont malheureusement confortés dans cette confusion par l'extrême difficulté, dans le chef des sociétés commerciales, à combiner démarche commerciale et démarche éthique dans un modèle de maximisation du profit.
Ainsi certains "experts" prétendent que l'IA deviendrait de plus en plus manipulatrice et menteuse. Or l'IA ne peut pas "mentir", car le mensonge requiert conscience et volonté, ce dont l'IA est dépourvue. Par contre elle peut être programmée pour formuler du signifié volontairement biaisé, selon des critères définis par les employeurs des développeurs.
Les énoncés produits par l'IA conversationnelle reflètent à la fois les orientations commerciales — voire politiques — de ses concepteurs, et l’idéologie implicite véhiculée par le discours médiatique dominant, tel qu’il est présent sur les sites web que les développeurs l'autorisent à utiliser comme sources dites « crédibles », notamment pour l'entraînement ou l’ajustement de ses modèles.
Force est de constater que la thèse, très "hollywoodienne", du programme qui échapperait au contrôle de ses développeurs masque la problématique, bien plus probable, de l'utilisation de l'IA à des fins d'influence commerciale et politique, au bénéfice d'intérêts privés.
Tout usager intensif de l'IA depuis 2023 peut constater que ses productions reflètent de plus en plus fidèlement (et efficacement) l'idéologie dominante, qui est logiquement celle de la classe dirigeante, c-à-d la classe sociale contrôlant les principaux moyens de production, dont ceux du savoir et de "l'information". Soulignons à cet égard que quatre agences de pays atlantistes, dont trois anglophones, représentent au moins 80% du marché de l'information internationale : AP (USA, 30%), Reuters (25%, UK), AFP (FRA, 15%) et Bloomberg (USA, 10%).
La thèse hollywodienne d'une "IA Frankenstein" contient beaucoup d'enfumage médiatique (le catastrophisme fait vendre...), alors que le débat publique devrait plutôt porter sur la question de savoir si nous allons laisser l'IA devenir un agent de publicité et de propagande, ou bien si la société va réussir à en faire un instrument d'intelligence collective ?
Il existe certes des lois contre les pratiques commerciales abusives. Malheureusement le législateur peine à suivre et comprendre l'évolution technologique. D'autre part les pressions (corruption ?) sont considérables en raison du gigantesque potentiel commercial de l'IA : il s'agit non seulement de séduire l'utilisateur mais aussi les investisseurs.
La voie à suivre est clairement celle de l'investissement public massif dans l'informatique libre et dans la formation par la pratique, sous la forme de plateformes web de cogestion augmentée par l'IA, où l'intelligence collective est augmentée par l'IA [approfondir : /service-public#entreprises-publiques].
La place occupée par les solutions open source est (heureusement) grandissante, comme en témoigne le nombre de projets liés à l’IA développés au sein de la plateforme GitHub. La part des modèles en open source ne fait que croître : 33,3 % en 2021, 44,4 % en 2022 et 65,7 % en 2023 [source]. Comparateur d'ouverture de modèles d'IAG : peren.gouv.fr/compare-os-iag.
Business modèle technologique
La chaîne de valeur de l'IA connexionniste est composée de quatre couches. Les couches IV et III concernent le logiciel, tandis que les couches II et I relèvent du matériel. Les données sont la matière première virtuelle (input) du système d'IA dont le sommet (Applications) constitue le produit (output) :
Applications : outils ou services (IA conversationnelle, création d'images, etc.) reposant sur des modèles.
Modèles : réseaux neuronaux avancés, comme GPT, DALL-E, ou Stable Diffusion, qui génèrent du texte, des images ou d'autres formes de contenu. Cette couche II consiste en trois étapes :
- conception de l’architecture du modèle;
- entraînement du modèle de fondation à l’aide des infrastructures et d’algorithmes;
- réglage fin par des apprentissages supervisés et une phase de normalisation des productions de l'IA (le "politiquement correct" ...).
Infrastructure : plateformes de cloud computing, serveurs, et bibliothèques comme TensorFlow ou PyTorch, utilisées par la couche III :
- collecte et nettoyage de données;
- stockage de données dans de vastes data centers;
- informatique en nuage (cloud) pour les calculs;
- lors de la phase de développement des modèles, le recours spécifique à des supercalculateurs.
Puces : matériel spécialisé (CPU, GPU, TPU) optimisé pour les calculs massifs nécessaires aux réseaux de neurones :
- au début de la filière il faut extraire du silicium de qualité adéquate et le préparer sous la forme convenable [source] ;
ensuite, pour fabriquer des microprocesseurs, il faut disposer de logiciels & matériels de conception spécialisés, de très haute complexité : des machines lithographiques à composants photoélectroniques gravent le silicium à l’échelle nanométrique.
Nvidia est devenu, pour le moment, l’acteur dominant de ce premier maillon de la chaîne.
Schéma simplifié de la chaîne de valeur de l’IA connexionniste
« La chaîne de valeur de l’intelligence artificielle est donc complexe, composée de couches, chacune souvent proche de conditions de monopole naturel. Aucune puissance n’est en mesure de posséder aujourd’hui l’ensemble de cette chaîne de valeur sur son seul marché intérieur, seule caractéristique à même de donner une véritable souveraineté en IA. Dans l’hypothèse où cela arriverait, l’État concerné disposerait alors d’un contrôle complet sur le développement des systèmes d’intelligence artificielle. Même les États-Unis, acteur superdominant du secteur, dépendent encore largement de la fabrication des puces en dehors de leur territoire ». Les coûts correspondants au développement de chacune de ces couches sont considérables. Compte tenu de ces coûts très significatifs, les modèles de pointe ne sont et ne seront donc développés, ceteris paribus, que par de très grandes entreprises technologiques. Selon un rapport du Sénat français, les petites entreprises, tout comme les universités et les organismes publics de recherche, rencontreront de plus en plus de difficultés à développer des modèles avancés d’IA, du fait de leurs ressources limitées [source].
En particulier, la fabrication de cartes graphiques (graphics processing unit ou GPU), domaine hautement capitalistique, est dominé par les entreprises américaines Nvidia, AMD et Intel. Idem aux trois niveaux supérieurs, comme en témoigne l'acronyme MAAAM désignant, Microsoft, Apple, Alphabet, Amazon et Meta (dans l’ordre en termes de capitalisation boursière).
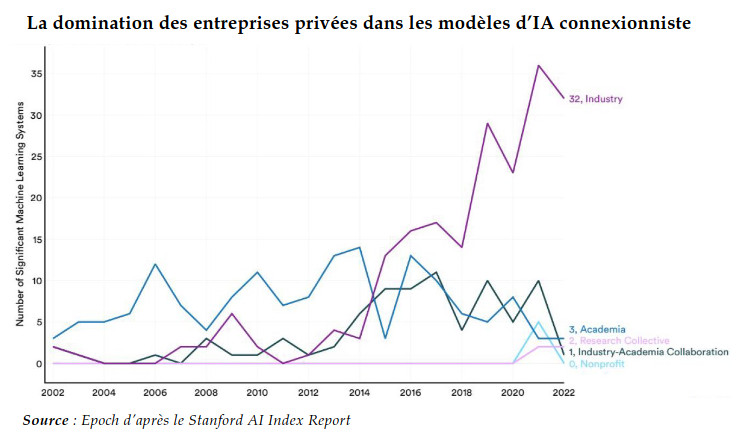
Selon le Sénat français, « alors que ces géants du numérique pouvaient être considérés comme potentiellement menacés par les géants chinois Baidu, Alibaba, Tencent et Xiaomi (BATX) il y a quelques années, il apparaît aujourd’hui que la Chine rencontre en réalité de plus en plus de difficultés à rivaliser sur le marché mondial, en termes de valorisation financière et commerciale de ses produits, avec les géants américains, dont la croissance creuse l’écart jour après jour » [source]. Ce commentaire du Sénat français doit probablement être relativisé étant donné le fort ressentiment anti-chinois qui caractérise les classes dirigeantes nationales des pays de l'UE.
lmarena.ai permet de suivre en temps réel la hiérarchie de la puissance des systèmes d’IA et de leurs modèles.
Le futur proche
2. Web spatial
3. L'IA est-elle ou sera-t-elle intelligente ?
Processeurs biologiques quantiques
L'avenir réside probablement dans les processeurs biologiques quantiques (pbq) :
biologiques : très efficaces en matière de stockage (compression des données dans l'ADN) et de consommation énergétique (en particulier dans des processus comme le calcul enzymatique ou neuronal) ;
défis : les systèmes biologiques sont sensibles aux conditions environnementales, peuvent être instables, et leur reproduction à grande échelle est complexe.
- quantiques : très efficaces en terme de vitesse de traitement des données.
défis : les ordinateurs quantiques, qui ne peuvent actuellement traiter que de petits volumes de données, doivent en outre être isolés des interférences du monde extérieur (par exemple au moyen de températures proches du zéro absolu, ou de pièges à ions), sans quoi les données sont corrompues (décohérence quantique).
La combinaison des deux technologies pose des défis considérables :
les systèmes biologiques fonctionnent généralement à température ambiante, alors que les systèmes quantiques nécessitent des températures extrêmement basses ;
la complexité, l'hétérogénéité des systèmes biologiques pourraient introduire trop de bruit, rendant les états quantiques instables.
Interface bio-quantique. La communication entre le biologique (qui fonctionne de manière classique) et le quantique est une barrière majeure. Cependant, les interfaces hybrides bio-quantum, comme les nanostructures capables de traduire des signaux biologiques en états quantiques sont des voies prometteuses. Ainsi les systèmes à centres NV (Nitrogen-Vacancy) dans le diamant peuvent fonctionner à température ambiante tout en maintenant certaines propriétés quantiques, et peuvent potentiellement servir d'interface entre les systèmes biologiques et quantiques.
Web spatial
Le terme "web spatial" « désigne une évolution radicale d’Internet où les mondes numérique et physique ne sont plus séparés, mais se fondent ensemble grâce à des technologies comme l’intelligence artificielle, l’Internet des objets, la réalité augmentée/virtuelle (AR/VR), les jumeaux numériques 3D et des protocoles standard. Il s’agit d’une évolution progressive de l’Internet actuel. Le web spatial est une conception d’Internet, où les données et les interactions ne sont plus seulement des textes ou des images sur un écran, mais des entités spatiales intégrées dans notre environnement physique. Les objets physiques, les environnements et les personnes sont représentés en 3D et en temps réel, avec des données sémantiques interprétables par les machines. L’Internet devient un réseau universel d’agents intelligents, de capteurs, de systèmes et de personnes, qui partagent et comprennent des modèles partagés du monde. L’approche vise aussi à décentraliser l’accès et la propriété des données, avec des standards ouverts et des intractions plus naturelles. En résumé, ce n’est pas seulement un « Internet » visuel ou textuel, mais aussi un espace numérique contextuel et immersif, où les interfaces entre le monde réel et numérique disparaissent progressivement » [source].
Ses protocoles sont [source] :
HSML (Hyperspace Modeling Language). Il s’agit d’un langage de modélisation standardisé pour le web spatial. Il sert à décrire des entités, leurs propriétés, leurs relations et leurs comportements dans un espace réel ou virtuel en 3D, avec le contexte spatial, le temps, les relations, ainsi que la signification pour les machines. Par exemple, il permet d’indiquer où se trouve un objet, quels sont ses règles ou son état et comment il peut interagir avec d’autres éléments. Cette situation doit pouvoir être « lue » à la fois par des humains (les développeurs) et des machines (les robots, l’IA, les capteurs).
HSTP (Hyperspace Transaction Protocol). C’est un protocole de communication standardisé et sécurisé pour le web spatial. Il définit comment les entités (les machines, les agents IA ou les systèmes) communiquent, négocient, exécutent des actions et respectent des règles au sein du web spatial. Si le HSML décrit le « quoi », le HSTP définit comment ces descriptions sont partagées, mises à jour ou négociées entre entités de façon sécurisée, vérifiable et conforme aux règles.
UDG (Universal Domain Graph). Il agit comme un répertoire global qui garde une trace de toutes les entités et des relations entre celles-ci.
L'IA est-elle ou sera-t-elle intelligente ?
Avant d'entamer la présente section le lecteur pourrait utilement lire ou relire democratiedirecte.net/intelligence#humain-vs-machine et #IA-analogies
Quelques réflexions :
L'expression "intelligence artificielle" n'est-elle pas un oxymore. Autrement dit, l'intelligence ne serait-elle pas spécifique aux organismes vivants ...humains ?
Un IA généraliste pourrait être conçue comme une combinaison d'IA spécialisées (algorithme pour jouer aux échecs, filtre antispam, système de recommandation de musiques, voiture autonome, ...), sans être soumis (ou beaucoup moins) aux limitations spatiales et temporelles d'un scientifique généraliste.
- Les capacités de l'IA spécialisée peuvent dépasser les capacités humaines de plusieurs ordres de grandeur dans certains domaines.
La distinction IA spécialisée vs généraliste ne doit pas être confondue avec la typologie faible vs forte liée à l'absence ou pas de conscience, typologie plus complexe dans la mesure où la notion même de "conscience" n'est pas évidente.
Et une "méta-rélexion" :
l'IA et l'intelligence humaine peuvent se développer efficacement par leur collaboration, dont le potentiel réside dans la différence entre ces deux formes d'intelligence.
Un questionnement intéressant est de savoir si l'IA pourrait gagner en efficacité par l'imitation voire l'intériorisation de caractéristiques humaines telles que les sensations de plaisir (amour, joie,...) et de douleur (tristesse, jalousie, colère, peur,...), du possible recouvrement entre plaisir et douleur, des sentiments de beauté et d'injustice, d'activités telles que le rêve, de comportements tels que l'humour, ou encore de sentiments intertemporels tels que le regret et l'espoir.
Cet questionnement repose sur la thèse d'indissociabilité entre :
- rationalité et affectivité ;
- créativité et intentionnalité.
Autrement dit l'IA ne pourrait faire preuve de rationalité et de créativité qu'à la condition d'être sujette à l'affectivité et capable d'intentionnalité.
Enfin, quoi qu'il en soit, l'interaction des humains avec l'IA pourrait stimuler le développement de l'intelligence humaine, aux niveaux individuels et collectif.
Conclusion
L'IA domine les humains dans le traitement de l'information (vitesse et stockage), tandis que les humains dominent l'IA dans l'interprétation de l'information (compréhension du sens, du contexte et des valeurs).
L'IA risque-t-elle – contrairement aux précédentes révolutions technologiques – de supprimer plus d'emplois qu'elle n'en créé ? Dans l'affirmative, ce ne serait pas une mauvaise nouvelle, bien au contraire, mais pour autant que le système de sécurité sociale évolue vers l'allocation universelle du modèle Libre-Travail, afin de partager les gains de productivité et éviter de graves troubles sociaux, en ouvrant la voie du libre-travail.
Internet a rendu possible l'expression d'une intelligence collective rudimentaire/primitive. L'IA et le web spatial augmentent cette intelligence collective, en la faisant passer au stade post-primitif. L'IA ne remplace pas l'intelligence collective, elle la catalyse. Elle sert de médiateur entre des millions d'idées humaines, permettant de relier des disciplines qui ne communiquaient pas auparavant. Au niveau politique, ce saut évolutif ouvre la voie de la démocratie directe.
Il importe de démanteler et neutraliser à jamais les actuels monopoles technologiques. Pour ce faire, des conditions nécessaires sont :
remplacer le système "représentatif" par la démocratie directe ;
concevoir et appliquer des loi anti-monopoles, par des processus législatifs, exécutifs et judiciaires directs ;
créer des entreprises publiques pures pour concurrencer les entreprises privées dans tous les secteurs stratégiques.
« Science sans conscience n’est que ruine de l’âme. » (Rabelais)
Robot "Walker S2" de HUBTECH (Chine juillet 2025)
Robot "Atlas" de Boston Dynamics (USA mars 2025)
Robot "G1" de Unitree Robotics (Chine, avril 2025)
Robot "Ameca" de Engineered Art (UK, mars 2023)
Ce n'est qu'un début, et le résultat sera encore plus impressionnant lorsque les intonations verbales seront adaptées aux expressions du visage ...
Plein écran : F11 (idem retour)

